AIだけでミュージックビデオを量産する
Sunoで作った自分の楽曲に、フルサイズのアニメMVを付ける。しかも1曲あたり数百円で、寝ている間に。 これは、それを実現するまでの2日間の制作記録です。映像生成はオープンウェイトの動画生成モデル MiniMax H3 をクラウドGPU上で動かしました。
作ったもの
キャラクターは楽曲ごとに固定され、カットは楽曲のビートに正確に同期し、 サビでは歌詞に合わせてキャラクターが口パクで歌います。 (上の埋め込みは軽量プレビュー版です)
なぜMiniMax H3か
H3は「動画と音声を同時に生成する」モデルですが、決め手は Ref2VAモード でした。 参照として画像(最大9枚)・動画(3本)・音声(合計15秒)を渡せて、 既存の音源を条件にして口パクを生成できる。つまりSunoの楽曲そのものを 「演技指導」として渡せるのです。これができるモデルは、商用サービスを含めてもほとんどありません。
さらにオープンウェイトなので、実行環境・速度・コストを全部自分でコントロールできます。
パイプラインの全体像
制作は「ローカルPCで頭脳、クラウドGPUで筋肉」の分業です。
- 楽曲解析(ビート・歌詞タイミング)
- ショット分割(ビート同期)
- プロンプト・ジョブ生成
- 結合・歌詞タイポグラフィ・仕上げ
- ジョブキュー
- 結果同期
- 1コマンドでPod起動
- モデル自動セットアップ
- 全カット生成 → 自己削除
一度ジョブを投げたら、あとは完全放置。GPUマシンは仕事を終えると自分で消えて課金が止まります。
01楽曲を解析する
Sunoからダウンロードしたmp3と歌詞テキストを渡すと、ローカルの解析ツールが ビート検出(librosa — 曲のBPMと全ビートのタイムスタンプ)と 歌詞アライメント(faster-whisper — どの歌詞が何秒に歌われるかを単語レベルで特定) を自動で行います。
コツはVAD(音声区間検出)を切ること。歌モノのサビは伴奏が厚く、VADが「音声じゃない」と 誤判定して丸ごと落とすことがありました。
02ストーリーボード(ショット分割)
解析結果から、2〜5秒のショットにビート同期で自動分割します。カット割りが全部ビート上に 乗るので、完成映像は音ハメが気持ちいい。
さらに「2回以上歌われるフレーズ=サビ・フック」を自動検出し、そこだけを口パクカットに 割り当てます。全カットで口パクさせると過剰なので、"歌っている見せ場"に絞るのが演出のコツでした。
03カット毎キービジュアル(GPT-Image2)
ここが画作りの心臓部です。各カットの「スタートフレーム」となる一枚絵を、画像生成AIで先に作り込みます。 共通ヘッダでキャラクター(髪型・衣装・配色)を固定して全カットで同一人物を維持し、 カットごとに構図・ショットサイズ(クローズアップ〜ドローン)・演出を指定。 「文字なし・9:16・セルアニメ調」を徹底します。
A young anime woman with a short red bob with pink underlights, teal eyes, silver earrings and a black o-ring choker, black studded leather jacket over a red shirt, ripped black skinny jeans and boots — the same singer, design, outfit and palette as the reference video.
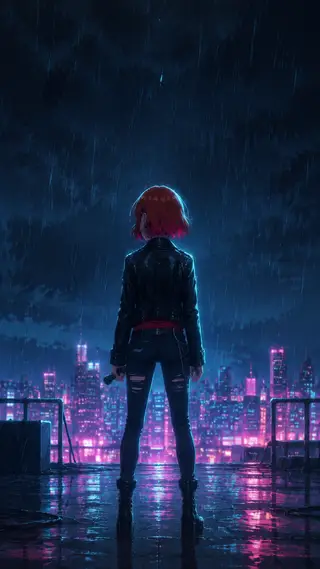
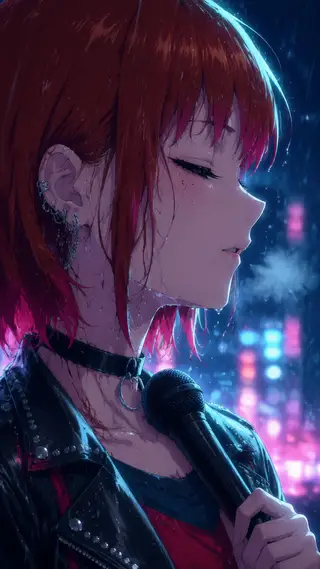
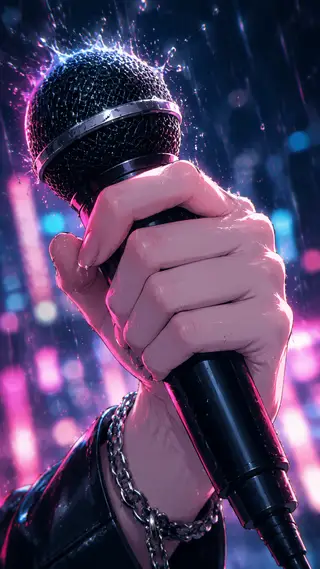
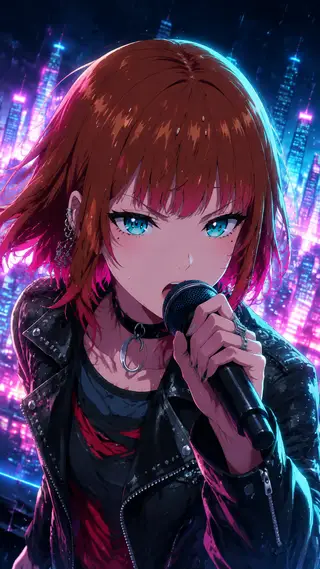
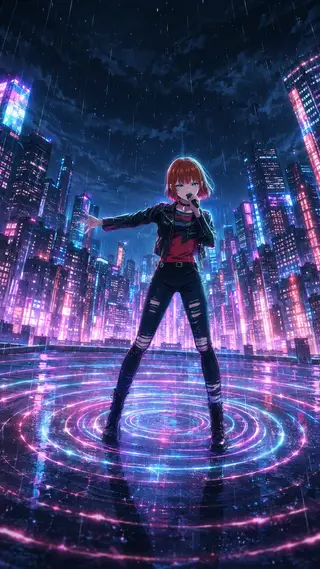
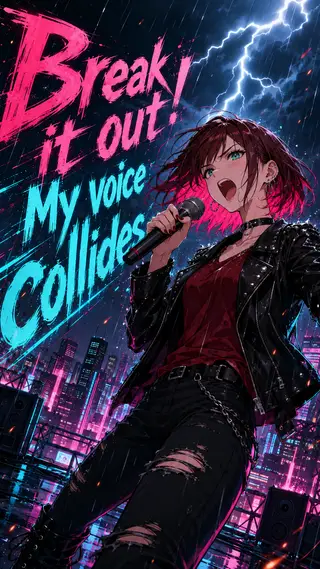
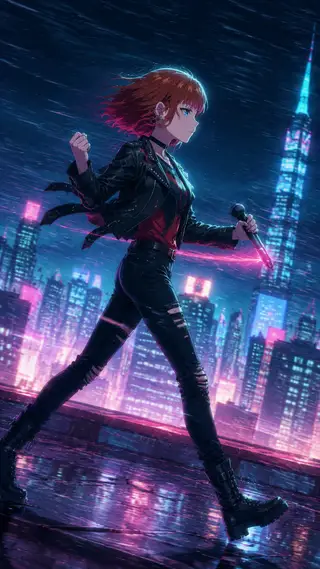
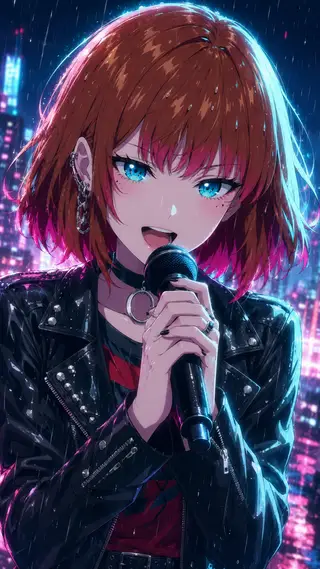
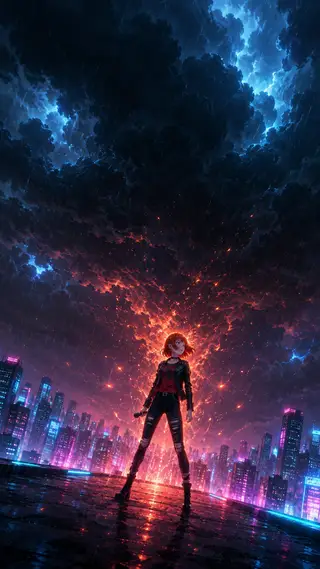
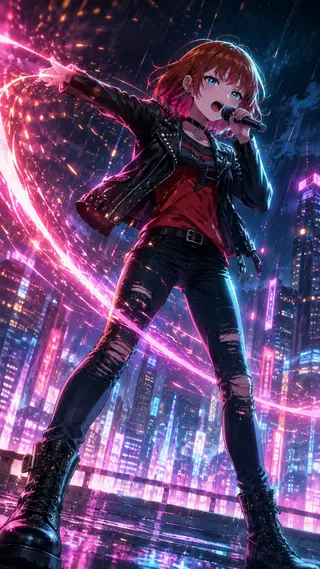
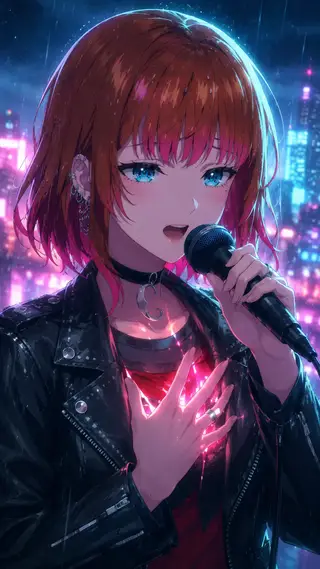
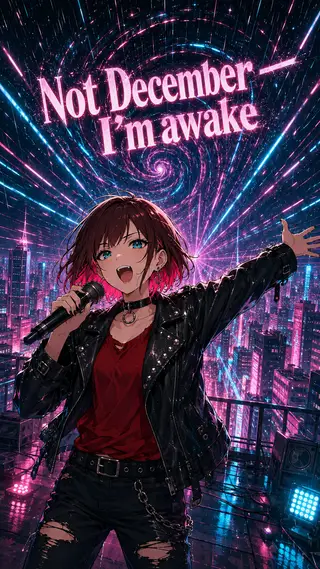
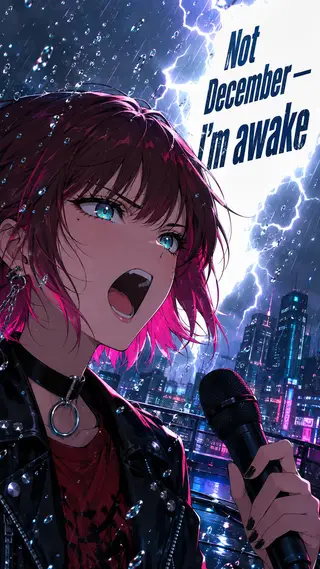
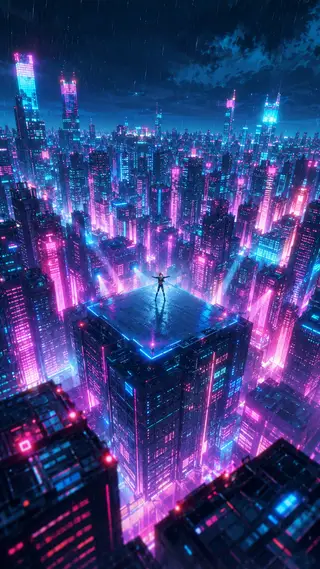
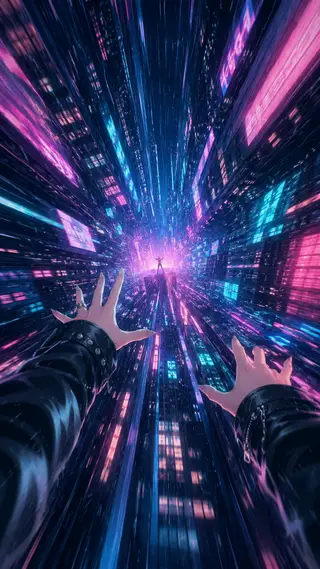
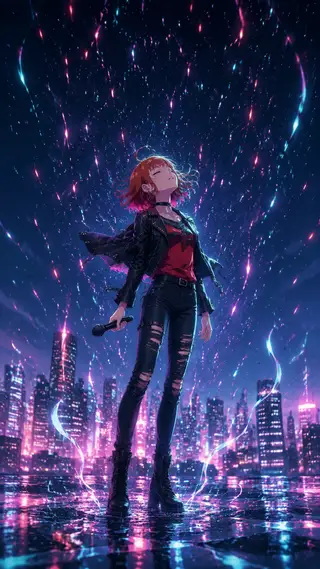
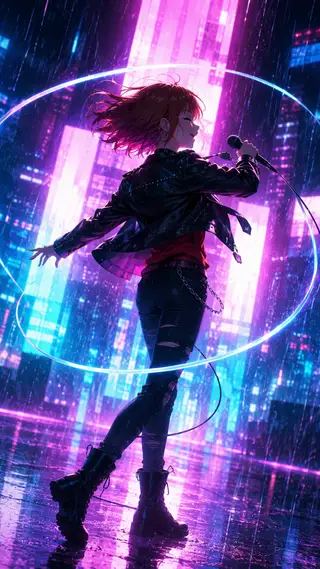
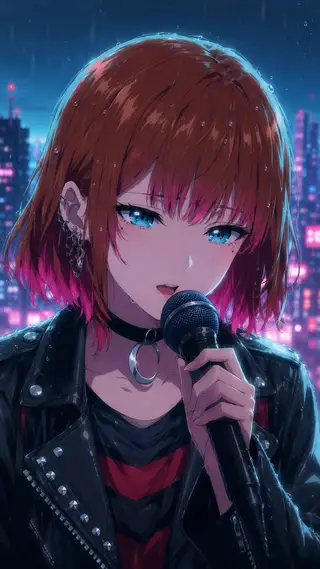
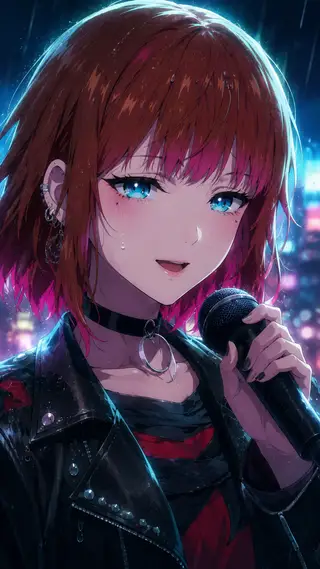
Not December(Hooks版)の全19カット分のキービジュアル。この一枚絵を動画生成の開始フレームとして 渡すので、構図と画風は画像側で保証され、H3は「動かす」ことに専念できます
04動画生成(MiniMax H3 / RunPod)
各カットに3種類の参照を渡します:
| 参照 | 役割 |
|---|---|
| 画像(カット毎キービジュアル) | 開始フレーム。構図・画風の錨 |
| 動画(既存のリファレンス映像) | キャラの同一性・世界観・カメラの空気感 |
| 音声(Suno楽曲の該当区間) | 口パク・歌唱表情の駆動源 |
生成はRunPodのRTX 4090で1カット2〜3分。19カットのHooks版なら約40分・100円未満で全カットが揃います。
05組み立て(ローカル)
生成された各クリップを:
- ビート境界にフレーム単位でトリム(H3の音声は破棄)
- 結合してSunoの原音源を1本敷く — 口パクは位置合わせだけでピタリと同期
- 歌詞タイポグラフィを合成(明朝系フォント、ボーカルのタイミングに同期してカットごとに配置が変わる演出)
- グレインで質感を統一
CapCutでの手動仕上げ用に、トリム済みクリップ一式+歌詞タイミング(SRT)+カット表も自動で書き出します。
06生成時歌詞デザイン — 歌詞を「字幕」ではなくシーンに描かせる
後処理で字幕を乗せる方式は、どうしてもMVの画に「後から貼った」感が出ます。 そこで最終的にたどり着いたのが、歌詞そのものを画像生成の段階でシーンのデザイン要素として描き込み、 H3にそれを保持したまま動かさせる手法です。
- GPT-Image2に「歌詞の正確な綴りを、シーンの幾何(空・壁・光条・雨)に沿ったタイポグラフィとして 統合せよ」というプロンプトで歌詞入りキービジュアルを生成(綴りは全数目視QC — 画像モデルの誤字は意外と多い)
- それをRef2VAの開始フレームにして、プロンプト側に「このタイポグラフィは完全保持。 文字の追加・削除・改変禁止。発光や揺らぎの微アニメは可」という保持指示を追加
- H3が、稲妻や光条と一体化した歌詞をそのまま保った状態でシーンを動かす
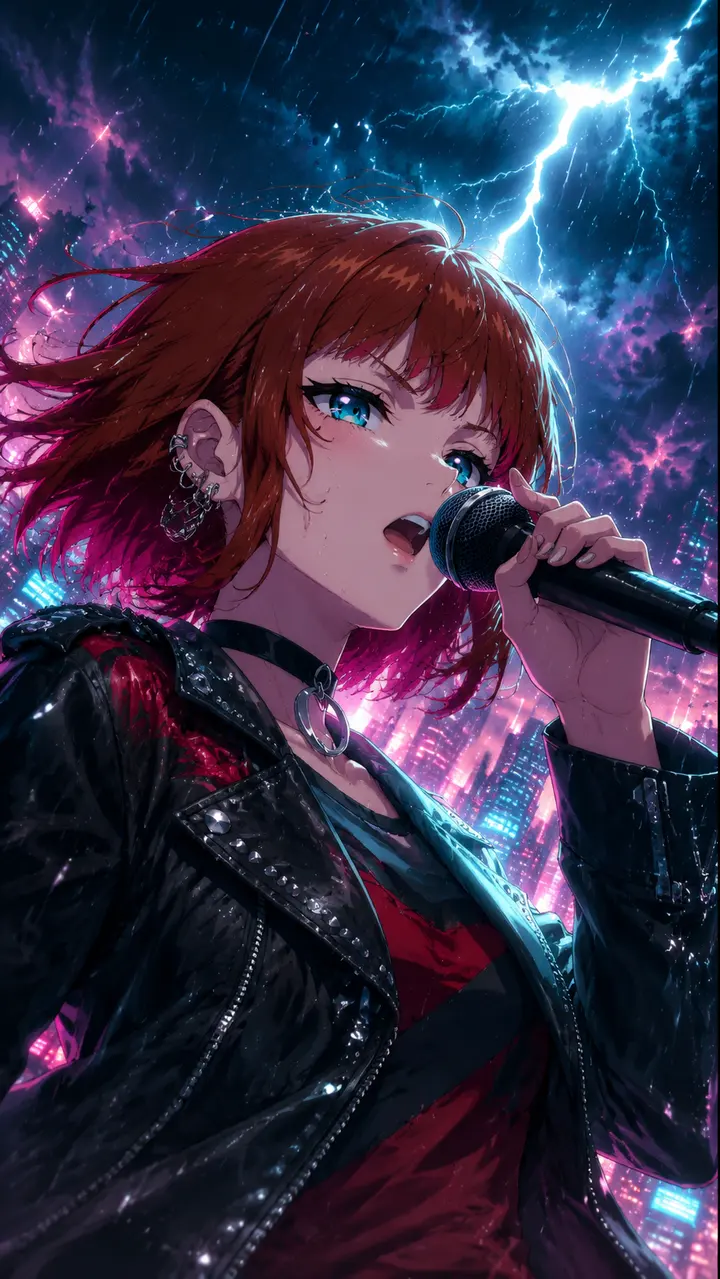
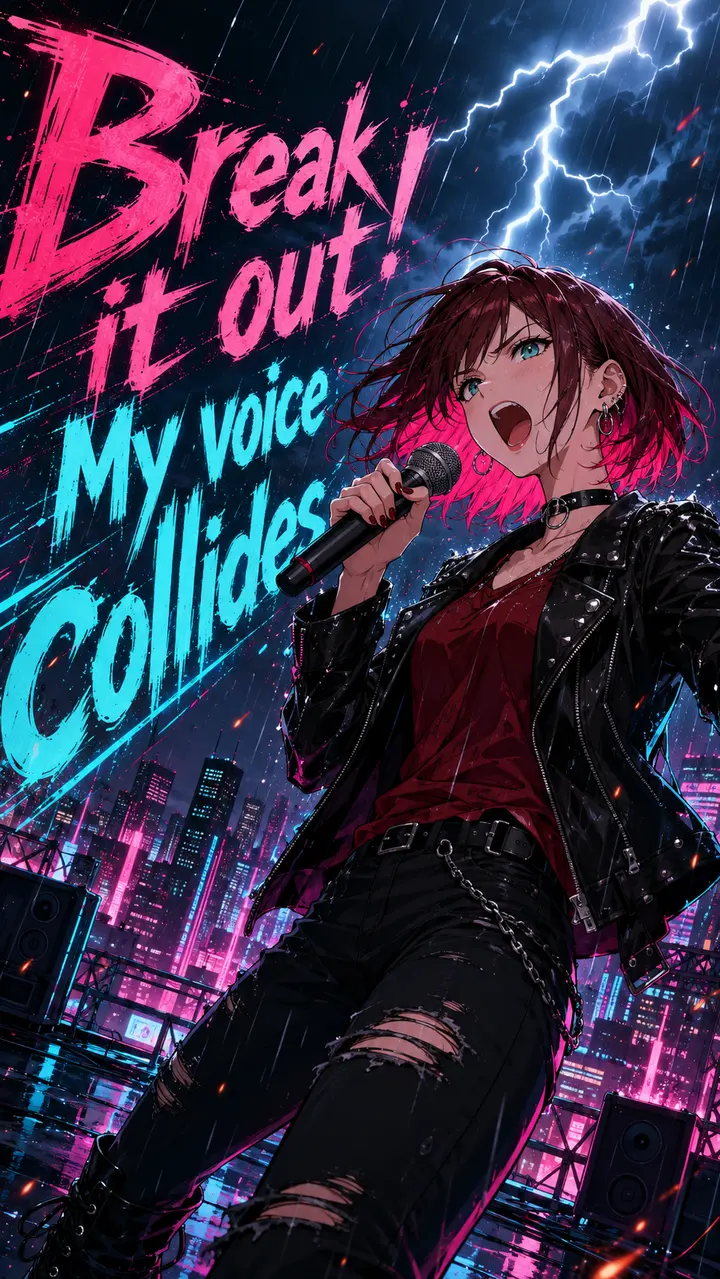
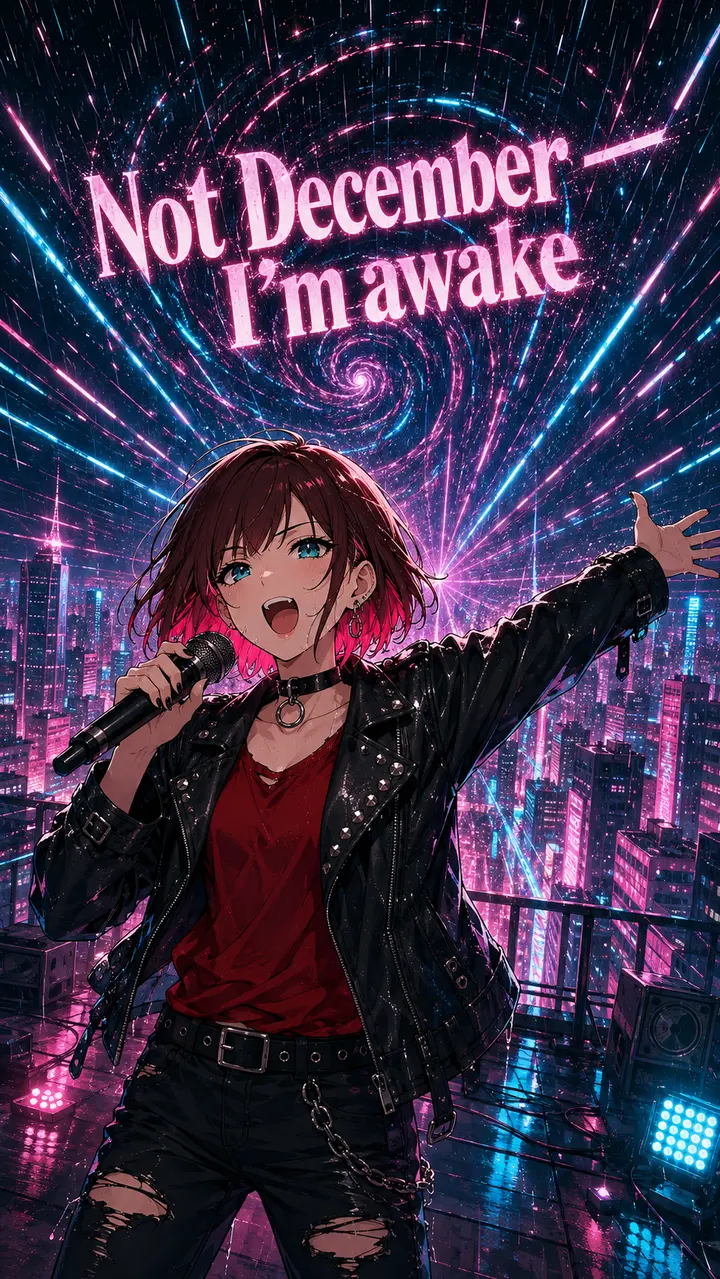
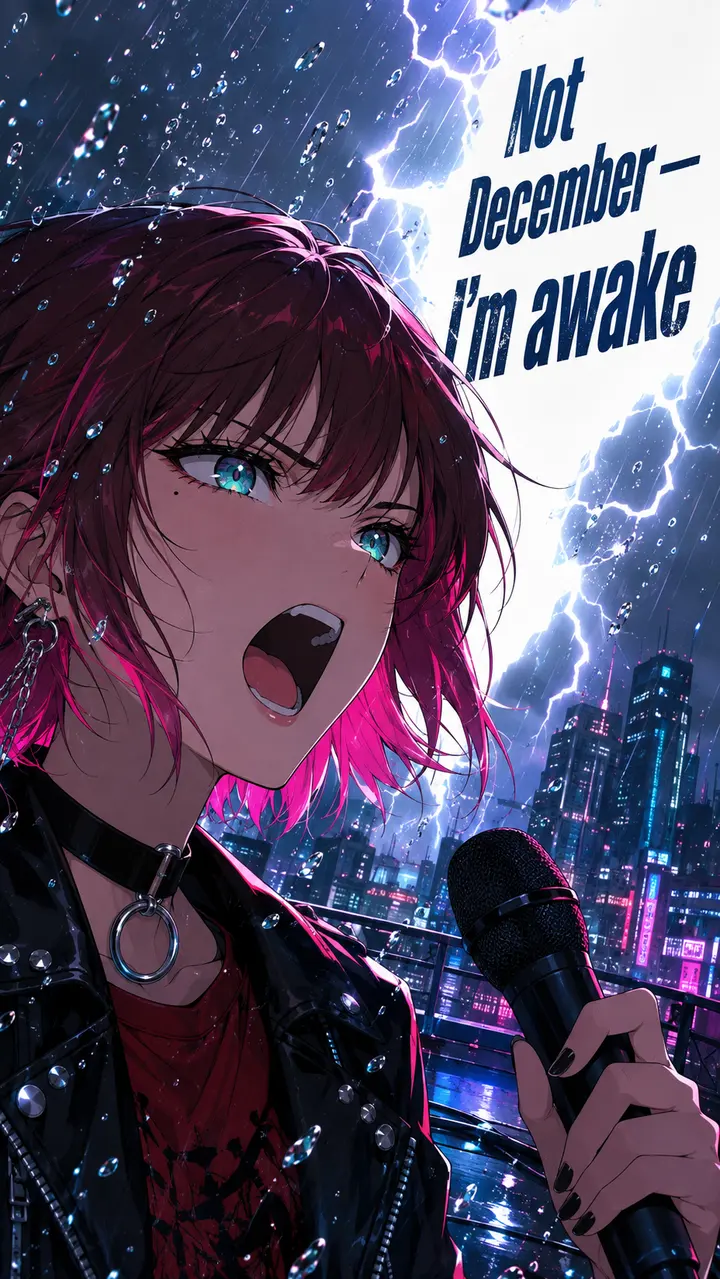
Not Decemberのサビ3カットで実験し、1カット目(「Break it out! My voice collides」が稲妻と共に 空へ炸裂するカット)は一発で完璧。歌詞がカメラワークや天候と同じ「演出の一部」になる — 字幕では絶対に出ない画です。
副産物の学びも2つ:
- ロングトーンは口パクさせない: 前の行の語尾を延ばすカットで律儀に音声同期させると、口がパクパクして破綻します。 「既に歌った母音を保持、新たな発語なし」と書くのが正解
- キービジュアルとモーション指示の整合が絶対: クローズアップの一枚絵に「ステージを歩き回る」と書くと、モデルは矛盾を解決しようとして 服装ごと別人にしてしまう
07リテイク運用 — 気に入らないカットだけ再生成
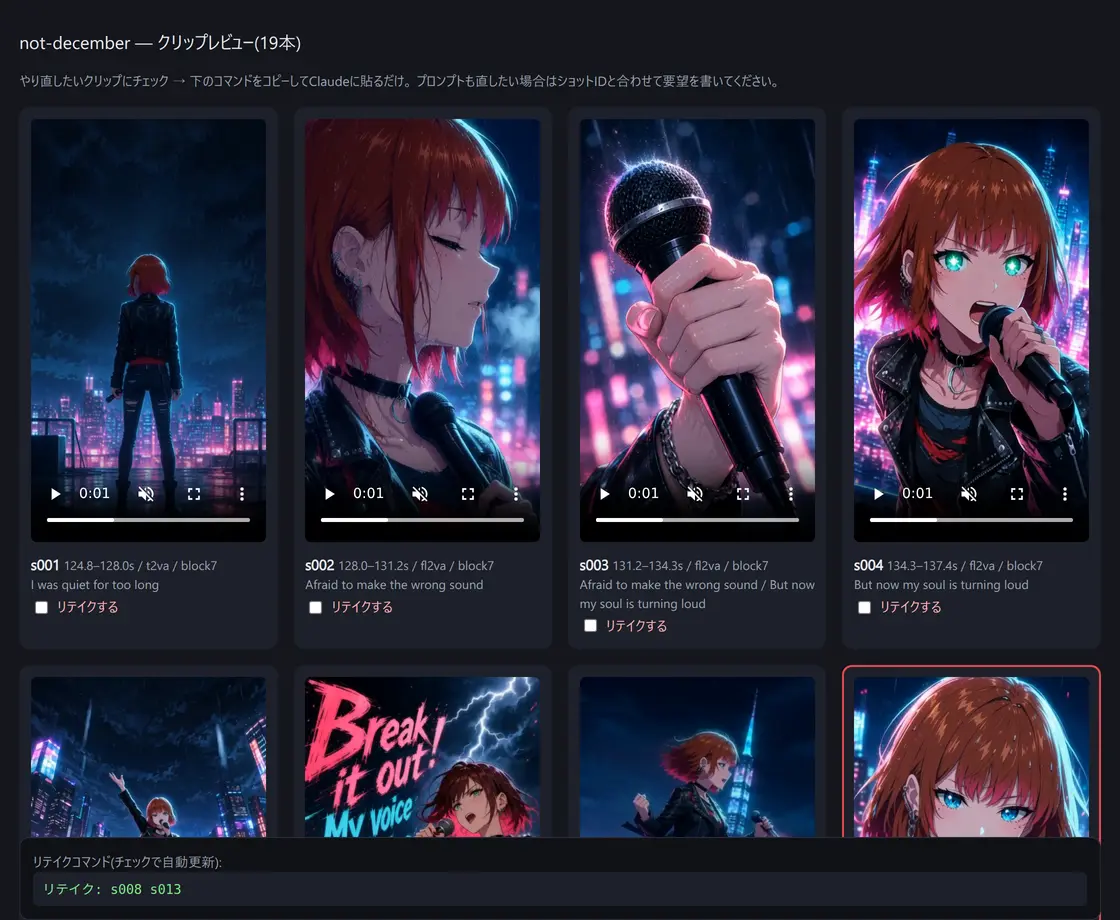
全カットをブラウザで一覧再生できるレビューページを自動生成し、気に入らないカットにチェックを 入れると「リテイク: s008 s013」というコマンドができあがります。それをAIアシスタントに貼るだけで、 該当カットだけが新しいシードで再生成され、MVが自動で組み直されます。 1カットあたり数円・数分なので、納得いくまで回せる。
数字で見る
| 項目 | 7月の傘は、まだ閉じない。(フル) | Not December(Hooks) |
|---|---|---|
| 尺 / カット数 | 194秒 / 62 | 60秒 / 19 |
| 口パクカット | 50(全ボーカル) | 8(フックのみ) |
| 生成GPU時間 | 約5.5時間 | 約40分 |
| 直接コスト | 約1,000円(試行錯誤込み) | 約100円 |
| 制作期間 | 2日(パイプライン構築込み) | 数時間 |
1曲目はインフラ構築と失敗の授業料込み。2曲目からは「ストーリーボード確定 → 翌朝完成」のペースです。
つまずきと学び
正直に書くと、順風満帆ではありませんでした。
- Colabの切断地獄: 無料〜Pro環境ではブラウザが閉じるたびにバッチが止まる。 1曲目は6回再開しました。→ 「キューをDriveに置き、何度切れても続きから再開できる」設計に したことで救われ、最終的にRunPodの使い捨てGPUに移行して完全放置を実現
- GPUホストのガチャ: 古いドライバ、RAM不足のホストを引いて起動失敗。 → CUDAバージョンとRAM下限を指定して配置するよう修正
- 日本語フォントの豆腐化: 字幕が「□□□□」に。→ Windows側のフォントを参照する仕組みに
- 生成の"学習レンジ": H3は約5秒未満の生成が学習外。短カットをどう扱うかは コストと品質のトレードオフで、実測しながら調整しました
これから
- 生成時歌詞デザインの適用範囲拡大(サビ・タイトルラインを曲ごとに選定)
- 生成の高速化実験(キャッシュ・アテンション最適化の組み合わせ比較)
- 月20曲ペースの量産と、伸びた曲のフル尺拡張
制作環境: Suno(楽曲) / GPT-Image2(キービジュアル) / MiniMax H3 + ComfyUI(動画生成) / RunPod RTX 4090(GPU) / 自作パイプライン(Python) / CapCut(仕上げ)