制作ノート
MiniMax H3 でMVを量産する
アーキテクチャと運用の全手順
このサイトのアニメMVは、1曲あたり $0.29〜$1.00 のGPU課金で作っています。60秒・10〜23カットで、生成にかかる時間は23〜41分。この記事はその仕組みを、同じことをやりたい人が辿れる粒度で公開するものです。
ふんわりした概要ではなく、使っているモデル・pinしたコミット・実際のコマンド・実測した数字をそのまま書きます。ここに書いていないものは使っていません。
先に断っておきます。ここに出てくる mvpipe は自作の非公開パイプラインで、インストールして使えるパッケージではありません。コマンドをそのまま打っても動きません。載せている理由は、各ステップが何を入力に取り何を出すかを具体的に示すためです。既製品はComfyUI・rclone・ffmpeg・RunPod APIで、mvpipe がやっているのはそれらの呼び出しと、カット表の管理・フレーム格子への丸め・検証・アセンブルです。同じ構造を組めば同じ結果が出ます。何を作ればよいかはステップごとの説明で分かるように書きました。
00結論から — なぜ「1カットずつ」なのか
最初に、この設計を決定づけた事実を書きます。H3の生成時間は、クリップの長さに対して二乗以上で悪化します。
3秒のカット(73フレーム)は約3分で終わります。ところが8秒(192フレーム)は75分かけても終わりません。実際に3回連続でタイムアウト(per-jobの上限4500秒)し、14.4秒(345フレーム)でも同じでした。この検証で $3.18 を使い、使える映像は1秒も得られていません。参照画像の枚数を5枚から3枚に減らしても変わらなかったので、参照数が主因という仮説も棄却しています。
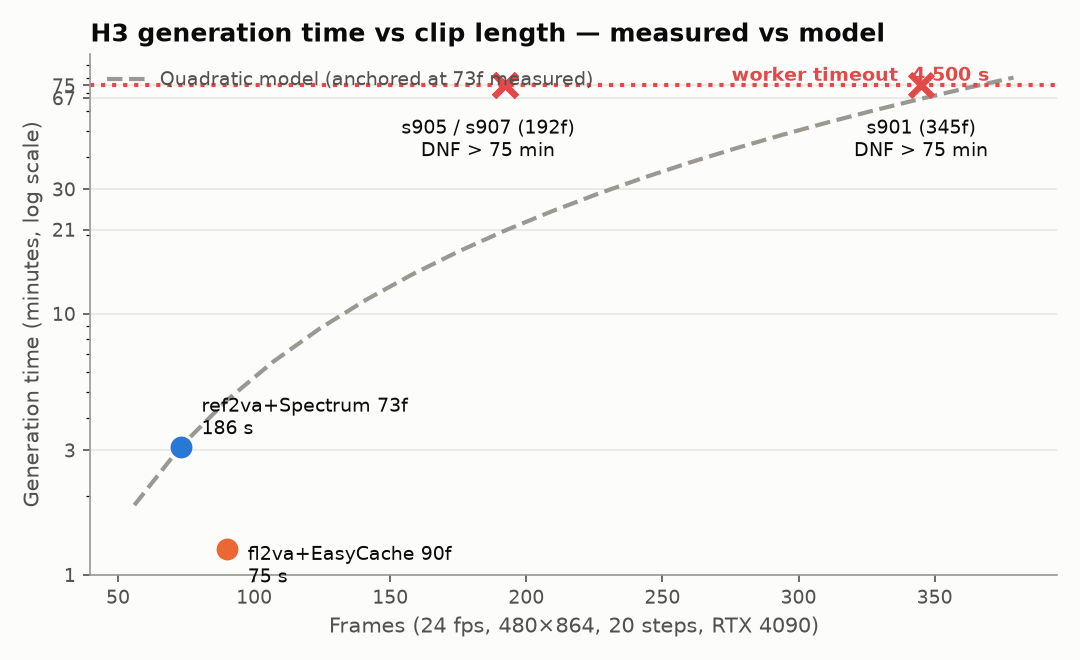
したがって「1回の生成で複数カットをまとめて作る」方式は、現行スタックでは成立しません。短いカットを1本ずつ生成し、編集で繋ぐ——これが唯一の実用解です。以降の設計はすべてここから導かれています。
01登場人物と役割
人間ひとりとAI2種、それに使い捨てのGPUで回しています。誰が何を持つかを先に書きます。
| 担い手 | 実体 | 持ち場 |
|---|---|---|
| micha | 人間(筆者) | 曲・歌詞・世界観の設計。GPT-Image2 でのキービジュアル制作とカット設計。すべての承認と検収 |
| Claude Code | Anthropic Claude のCLI(WSL2上) | michaとの対話でカット割りを設計。パイプライン本体の実装。ジョブ構築・投入・回収・アセンブルの実行 |
| Codex CLI | OpenAI Codex CLI 0.147.0(WSL2上) | 不足したキービジュアルの生成のみ。imagegen 組み込みツールを使う |
| RunPod Pod | RTX 4090 24GB(community / secure) | 動画生成だけ。終わったら自己削除する使い捨て |
Codex CLI を画像生成に使っているのは、ChatGPTプランの範囲内で追加コストが $0 だからです。起動は以下の形で、設定既定のcodex系モデルはChatGPTアカウントで拒否されるためモデルを明示指定します。参照画像はカレントディレクトリに置きます。
codex exec --sandbox workspace-write -c model="gpt-5.4"スループットは1枚あたり8〜10分・順次。24枚の生成と承認を1曲で回した実績があります。ただし現状の主力は micha が GPT-Image2 で作るキービジュアルで、パイプライン内の Codex CLI は不足分を埋める役です。
02アーキテクチャ
設計の原則は5つです。これは好みではなく、事故と課金から決まったものです。
- ローカルが正、GPU Podは使い捨て、状態はすべてGoogle Drive。Podは落ちても構わない前提で組む
- 音楽と映像の同期は編集レイヤーで取る。H3が出力する音声は捨て、Suno原音源(48kHz)を敷き直す
- 口パク(ref2va)は歌唱・タイトル回収カットに限定。他は高速な fl2va を使う
- 歌詞を焼き込んだキービジュアルは、その歌詞が実際に歌われる時だけ使う
- GPU課金の前に必ず人間が承認する。kvレビュー承認と preflight 承認の2つを越えて初めて launch(=課金開始)に進む
構成要素は4つです。ローカルのPythonパイプライン、Drive上のキュー、使い捨てPod、そしてCodex CLIのキービジュアル生成ライン。
| 場所 | 中身 |
|---|---|
pipeline/mvpipe/ | 自作の制御パイプライン(非公開)。Python 3.13 / uv / WSL2、テスト180本以上(pytest, ruff)。下の表が全モジュールと担当範囲 |
gdrive:H3/MiniMax-H3-Native-Colab/ | ジョブキューと成果物。mv/<song>/ 配下に jobs / refs / results / state / out |
worker/ | Pod上で動くワーカー。起動時にDriveへアップロードされる |
songs/<song>/ | 曲ごとの作業場。音源・歌詞・解析結果・カット表・参照画像・完成品 |
mvpipe の中身は以下の単位に分かれています。自分で組む場合、必要な機能はこの14個です。
| モジュール | 担当 |
|---|---|
config.py | 既定値(480×864・24fps・20steps・res_multistep/simple・Ref2VA参照上限) |
analyze.py | ビート/ダウンビート検出 + Whisper歌詞アライメント |
framing.py | H3のフレーム制約 17k+5 への丸めとプロファイル検証 |
shotlist.py | カット表 shotlist.yaml の生成と検証 |
keyvisuals.py | 手動生成用のkvプロンプト集を出力 |
codexkv.py | Codex CLI を叩いてkv生成 + kv_review.html を出力 |
jobs.py | カット表とプロンプトからジョブJSON。高速化レーン選択・音声セグメント抽出・シード固定・参照検証 |
verify.py | preflight(起動前チェック表)と results(ffprobe全数照合) |
sync.py | rclone で Drive キューを操作(push / pull / status) |
runpod.py | Pod の起動・停止・状態(GraphQL)。CUDA/RAM要件のピン留めと残高表示 |
retake.py | takeカウンタを進めて Drive 上で再キュー |
review.py | クリップ格子のレビュー画面を出力 |
post.py | トリム→結合→Suno原音源→ASS歌詞→LUT/グレイン→出力 |
capcut_draft.py | CapCutドラフト書き出し(手編集する場合) |
Drive をキューにしているのは、Podが消えても状態が残るからです。Podのテレメトリ(CPU/GPU使用率)は信用しません。community Podでは実態と合わないことがあるためで、健全性の判断は results/ と failed/ にファイルが出現したかどうかだけで行います。
03環境を固定する
再現するうえで最も重要なのがここです。すべてコミットハッシュでpinしています。H3周辺はツールの更新が速く、pinを外すと同じ入力から同じ出力が得られなくなります。
| 対象 | 固定値 |
|---|---|
| ComfyUI | 9a9fdb10 |
| KJNodes | 195d312 |
| Spectrum | 4b9a7d11(v0.2.5) |
| SageAttention | thu-ml/SageAttention @ d1a57a546c3d395b1ffcbeecc66d81db76f3b4b5(このコミットからビルドしたwheelをDriveにキャッシュして再利用) |
| PyTorch | 2.11.0+cu128 |
| ベースイメージ | runpod/pytorch:1.0.2-cu1281-torch280-ubuntu2404 |
| モデル | Comfy-Org/MiniMax-H3 @ 0543966fbdce5ba05709a8f2031c94bdba629b4a |
| Motion Context ノード | f80e36bc1d7887a143b12e6645313fd6b9cd2aee(0.3.1) |
重みは HuggingFace の Comfy-Org/MiniMax-H3 から、上のリビジョンを指定して hf_hub_download で取得します。ワーカーは取得後にサイズと sha256 を照合します。使うファイルは5つです。
| ファイル | 用途 | sha256(先頭16桁) |
|---|---|---|
diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors | fl2va / t2va 本体 | e889202c41dafb67 |
diffusion_models/minimax_h3_ref2va_pruned_int8_convrot.safetensors | ref2va 本体 | 9255f52b6677845a |
text_encoders/qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | テキストエンコーダ | 35a88d51044231fe |
vae/minimax_h3_video_vae_fp16.safetensors | 映像VAE | 7c1f131492e7edda |
vae/minimax_h3_audio_vae_fp32.safetensors | 音声VAE | 8e505d95dd1561d4 |
生成の既定値は 480×864(縦9:16)・24fps・20 steps・res_multistep/simple。Pod選定では CUDA>=12.8 かつ RAM>=45GB をピン留めしています。
H3には2つの厳しい制約があります。どちらも設計時に効いてきます。
- フレーム数は 17k+5 の値しか取れません。73f=3.04秒、158f=6.58秒、192f=8.0秒といった飛び飛びの値です。学習レンジは124〜362フレーム。任意の秒数を指定できないので、カット尺は必ずこの格子へ丸めることになります
- 解像度は32の倍数。参照キービジュアルは、キャンバス比へ事前にセンタークロップしておく必要があります。fl2va は非等比ストレッチをかけてくるので、比が合っていないと絵が歪みます
ほかに、Ref2VA へ渡す音声は15秒以下、ジョブ単位のタイムアウトは4500秒です。
04生成モードの使い分け
3つのモードがあり、カットごとに選びます。速度が3倍違うので、この選択がコストを決めます。
| モード | 使う場面 | 参照 | 高速化 | 速度(4090実測) |
|---|---|---|---|---|
ref2va | 口パクが要るカット(歌唱・タイトル回収) | 画像≤9 + 動画≤3 + 音声1 | Sage + Spectrum | 約2.55秒/フレーム |
fl2va | 歌っていないカット | first_frame = キービジュアル | Sage + EasyCache | 約0.84秒/フレーム |
t2va | テキストのみ(冒頭など) | なし | Sage + EasyCache | fl2va と同等 |
ref2va は口パクが合いますが fl2va の約3倍遅いので、歌っているカットとタイトルを回収するカットだけに使います。全編を ref2va で作ると $1.00 かかるところが、混成にすると $0.29〜$0.51 に下がります。これが冒頭の価格差の正体です。
高速化の組み合わせもモードで変えています。ref2va は Sage + Spectrum、fl2va と t2va は Sage + EasyCache。A/Bで測った結果、ref2va に EasyCache を使うと逆に遅くなりました(73フレームで185.8秒 → 195.5秒)。
051本作るまで — 10ステップ
ここからが本題です。実際のコマンドを添えて、順に追います。<s> は曲のスラッグ、作業ディレクトリは pipeline/ です。
| ステップ | やること | 担い手 | |
|---|---|---|---|
| 01 | 素材受領 | Suno の mp3 と歌詞を songs/<song>/ へ置く | micha |
| 02 | 解析 | ビート・ダウンビート検出と歌詞アライメント | ローカル |
| 03 | 設計 | 窓・カット割り・モード選択・kv対応表 | micha + Claude |
| 04 | キービジュアル | micha が GPT-Image2 で作成 + 不足分を Codex CLI が生成 → 承認 | micha + Codex CLI |
| 05 | ジョブ構築 | shotlist と prompts からジョブJSONを組む | ローカル |
| 06 | 投入 | Drive へ push → RunPod の Pod を起動 | ローカル |
| 07 | 生成 | Pod がキューをドレインする | Pod |
| 08 | 回収・検証 | pull して ffprobe で全数照合、必要ならリテイク | ローカル + micha |
| 09 | アセンブル | トリム・結合・Suno原音源・歌詞デザイン | ローカル |
| 10 | 納品 | out/ へ出力 | ローカル |
解析(ステップ2)
uv run python -m mvpipe.analyze ../songs/<s>/audio.mp3 \
  --lyrics ../songs/<s>/lyrics.txt --language ja --no-vad
ここが後工程すべての土台になります。やっていることは3つです。
1. ビート検出。librosa で音源を読み、beat.beat_track でBPMとビート位置を出します。ダウンビート(小節頭)は先頭ビートから4拍ごとに取ります。拍子解析まではしていません——4拍子前提の割り切りです。
2. 歌詞の書き起こし。faster-whisper の medium モデルを CPU・int8 で回し、単語単位のタイムスタンプを取ります。--no-vad が必須なのはここで、音声区間検出を有効にすると音圧の高いサビを「非音声」と誤判定して丸ごと落とします。伴奏が厚い曲ほど落ちるので、既定で切っています。
3. 歌詞ファイルとの突き合わせ。Whisperの書き起こしは誤字を含むので、そのままでは使えません。手元の正しい歌詞と書き起こしを文字単位で照合し(difflib.SequenceMatcher)、一致した文字の時刻を正しい歌詞側へ移します。一致しなかった文字は、その行の中で線形補間して埋めます。
この方式の利点は、表示する文字列が常に手元の歌詞であることです。Whisperが「未定稿」を「みていこう」と書き起こしても、時刻だけを借りて表記は正しいまま保てます。
出力: analysis.json
1曲ぶんの構造がこの1ファイルに入ります。実際の出力から抜粋します。
{
  "schema_version": 1,
  "duration_s": 248.36,
  "bpm": 130.81,
  "beats":     [0.0, 0.46, 0.92, ...],   // 537個
  "downbeats": [0.0, 1.86, 3.71, ...],   // 135個(4拍ごと)
  "sections": [
    { "label": "block1", "start": 0.0,   "end": 22.74, "vocal": true },
    { "label": "block2", "start": 22.74, "end": 36.96, "vocal": true },
    ...
  ],
  "lyrics": [
    {
      "line": "予定はまだ 鉛筆書き",
      "start": 0.0, "end": 3.94,
      "words": [
        { "w": "予定はまだ", "start": 0.0,  "end": 2.26 },
        { "w": "鉛筆書き",   "start": 2.26, "end": 3.94 }
      ],
      "matched_ratio": 1.0,
      "low_confidence": false
    },
    ...
  ]
}
押さえておきたいのが matched_ratio と low_confidence です。行ごとに「どれだけ照合できたか」が残るので、怪しい行だけを目視できます。上の曲では85行中73行にタイミングが付き、残りは [Intro] のようなセクション記号でした。
sections は歌詞ブロックから組み立てます。歌のかたまりを blockN(vocal: true)とし、その間に一定以上の空きがあれば intro / interludeN / outro として器楽区間を差し込みます。区間は必ず時間軸を隙間なく覆います——カットは全区間に割り当てる必要があるので、穴が空くと設計が破綻するためです。
後工程はこのファイルだけを見ます。どの60秒を切るか(窓)は sections と downbeats から決め、カットの切れ目はダウンビートに合わせ、焼き込む歌詞と実際の歌唱時刻の一致は lyrics で保証します。音源そのものを再解析する工程は、以降どこにもありません。
設計(ステップ3)
ここが micha と Claude の対話です。analysis.json のビートと歌詞タイミングを見ながら、どこで切るか、どのカットを口パクにするか、どのキービジュアルを当てるかを決めます。micha が GPT で作った設計書(共通ヘッダー+カット表+口パク指定)があれば、それを最優先で移植します。自動生成に任せるより、設計が先にあるほうが仕上がりが良いためです。
決まった内容は曲別のビルダー make_<s>.py に書き下し、shotlist.yaml(カット表:id / 開始 / 終了 / モード / kv / タイポグラフィ)と prompts.yaml(カット毎プロンプト)を生成します。カット尺の 17k+5 への丸めは framing.py が行います。
キービジュアル(ステップ4)
uv run python -m mvpipe.codexkv ../songs/<s> --spec multicut_kvgen.yaml不足分を Codex CLI に生成させます。仕様は multicut_kvgen.yaml(カット定義+style_tail)で、style_tail を上書きすると歌詞の焼き込みもできます。出力と同時に kv_review.html が生成され、マウスオーバーで原寸表示、クリックで別タブ、カット毎にコメントを書ける画面になります。
ここで micha が全枚チェックします。特に見るのは焼き込み文字の綴りです。直したいカットにコメントを書くと、再生成コマンドが自動で組み立てられます。
uv run python -m mvpipe.codexkv ../songs/<s> --spec <spec> \
  --force --cuts c01 --note c01="..."
ジョブ構築と起動前チェック(ステップ5)
uv run python ../songs/<s>/make_<s>.py
uv run python -m mvpipe.jobs build ../songs/<s>/
uv run python -m mvpipe.verify preflight ../songs/<s>/
jobs build が shotlist と prompts からジョブJSONを組みます。このときモード別の高速化レーンを自動選択し、ref2va用の音声セグメントを 32kHz wav で自動抽出し、シードを固定し、参照の存在を検証します。
preflight は起動前チェック表を出します。向き(縦横)、参照の有無、尺、推定生成時間が一覧になります。これを micha が見て承認するまで、GPUには一切課金が発生しません。
投入と生成(ステップ6〜7)
uv run python -m mvpipe.sync push ../songs/<s>/ --shots s001 s002 ...
uv run python -m mvpipe.runpod launch ../songs/<s>/ [--cloud secure]
push は rclone で参照とジョブを Drive の jobs/pending/ へ送ります。done が空でない場合はガードがかかります。launch は community を先に試し、確保できなければ secure へフォールバックします。起動時に残高を表示します。
Pod側は start.sh が ffmpeg と rclone を入れ、torch 2.11.0+cu128 を確認してから h3_worker.py を起動します。ワーカーはモデルをHuggingFaceから落とし、ComfyUIを立ち上げ、pending を取り込んで生成し、results/ へ書き出して done へ移します。キューが空になると自分でPodを削除します(AUTO_TERMINATE)。
クラッシュしても running のジョブは pending へ戻されるので、取りこぼしません。失敗したジョブは failed/<shot>.error.json にステージ・エラー・経過秒が残ります。
実行中のPodがいる曲へ push してはいけません。ミラーがPod→Driveの一方向なので、書き戻しが衝突します。
回収と検証(ステップ8)
uv run python -m mvpipe.sync status ../songs/<s>
uv run python -m mvpipe.sync pull ../songs/<s>/
uv run python -m mvpipe.verify results ../songs/<s>/
verify results は ffprobe で全数照合します。尺・解像度・フレーム数が指定どおりか、meta.json のシードと一致するかを見ます。目視の前に機械で落とせるものを落とす、という順序です。
そのうえで review.html(クリップを格子状に並べたレビュー画面)で micha が見ます。直したいカットを選ぶと、リテイクコマンドが組み立てられます。
uv run python -m mvpipe.retake ../songs/<s> s0XX ...リテイクは take カウンタを進めて Drive 上で再キューします。push は不要で、Podが動いていればそのまま拾います。
アセンブル(ステップ9〜10)
rm -rf ../songs/<s>/out/intermediate
uv run python -m mvpipe.post ../songs/<s>/各クリップを所定のスロットへトリムし、結合し、Suno原音源(48kHz)を敷き直します。H3が生成した音声はここで完全に捨てます。歌と口の動きを合わせるのは生成側の仕事ですが、音そのものは原音源が正だからです。
歌詞を画面に出す場合は ASS 字幕でデザインします。位置を循環させ、長い行はフォントを自動縮小し、画面端でアンカーをクランプします。キービジュアルに歌詞を焼き込んだカット(typography=model)はスキップされます。最後にLUTとグレインをかけて出力します。
out/intermediate/ の削除は必須です。中間ファイルをキャッシュしているので、消さずに再実行すると前回の結果が混ざります。
06QC — どこで人間が見るか
自動化の目的は人間を外すことではなく、人間が見るべき場所を絞ることです。関門は5つ。うち4つが人間の目視、1つが機械の全数検証です。課金を止められるのは前の2つ(kvレビューと preflight)で、残りは作り直しの判断に使います。
| 関門 | 種類 | 見るもの | 止める理由 |
|---|---|---|---|
| kvレビュー | 人間 | キービジュアル全枚(焼き込み文字の綴り) | 誤字のまま生成すると全カットが無駄になる |
| preflight | 人間 | 向き・参照・尺・推定時間の一覧 | ここを越えると課金が始まる |
| verify results | 機械 | ffprobeで全クリップの尺・解像度・シード照合 | 目視の前に機械で落とせるものを落とす |
| クリップレビュー | 人間 | 各カットの絵と動き | リテイク対象の判断 |
| 完成尺の確認 | 人間 | 繋ぎ目・音ズレ・歌詞の可読性 | カット単体では見えない問題が出る |
運用上のルールとして決めていることが他に3つあります。RunPodの実行報告には毎回、消費額と残高を含めること。歌詞を焼き込んだキービジュアルはその歌詞が実際に歌われるカットだけに使うこと。そして post の再実行時は out/intermediate/ を必ず消すこと。
07実績
実運用した3曲の計測値です。数字はすべて実測で、推定は含みません。
| 曲 | 日付 | 尺 | カット | GPU時間 | 費用 | リテイク |
|---|---|---|---|---|---|---|
| Not December | 2026-08-10 | 60.6秒 | 19 | 40分 | $1.00 | 少数あり |
| 響け、夜 | 2026-08-11 | 59.4秒 | 23 | 41分 | $0.51 | なし |
| Scarlet | 2026-08-11 | 56.0秒 | 10 | 23分 | $0.29 | なし |
Not December は全編 ref2va で作ったため $1.00 かかりました。以降の2曲で ref2va を歌唱カットに絞った結果、$0.51、$0.29 と下がっています。Scarlet はカット数が10と少なく、23分・$0.29 で完成しました。リテイクは後の2曲ではゼロです。
キービジュアル生成のコストは $0(ChatGPTプラン内)。micha が GPT-Image2 で作る分も ChatGPT プラン内なので、画像生成の変動費はゼロです。したがって1本あたりの実質的な変動費はGPU課金だけになります。
08捨てた選択肢
参考にする方のために、試して不採用にしたものも書いておきます。
- マルチカット(1回の生成で複数カット) — 8秒窓・14.4秒窓ともタイムアウト。3回試して $3.18 を消費し、映像は0秒。実装は
multicut.pyとして残していますが使っていません - ref2va への EasyCache — Spectrum より遅くなったため不採用(73フレームで 185.8秒 → 195.5秒)
- Podのテレメトリ監視 — community Podの CPU/GPU 使用率は実態と合わないことがあるため、健全性の判断材料から外しました
- H3の生成音声 — 使いません。音は Suno 原音源に統一します
09これから
H3はまだ研究開発から量産確立へ移る段階で、固定費の投資は方式の切り替え判断が済んでからにしています。キービジュアルは現時点では micha が GPT-Image2 で作る分が主力で、パイプライン内の自動生成をどこまで任せるかはこれからの検討です。
直近の課題は Drive ミラーの双方向化(現在はPod→Driveの一方向のため、実行中の曲へpushできない)と、マルチカットのカット秒数精度を測る cutcheck.py の稼働です。
個別の曲でどう作ったかはSuno × MiniMax H3 制作記、制作日誌 2026-08-12、流転 ─ Amor manet 制作記に書いています。特に「流転」は、この記事で触れたカット間の繋ぎを1日かけて検証した記録です。