2026.08.24 — 08.25
初のフル尺、54カット
これまで作ってきたMVはすべて60秒でした。Suno の Hooks に合わせて、曲のいちばん強い60秒を 切り取る作り方です。この曲で初めて、4分38秒の全尺に挑みました。
規模は4.6倍。カットは10前後から54へ。何が変わるかは、やってみるまで分かりませんでした。 結論を先に書くと、60秒では表に出なかった設計の粗さが、この規模で一つ残らず出ました。
仕組みそのものは MiniMax H3 でMVを量産する、 演出の選択肢は MV制作で選べる7つの軸 にあります。
この曲の数字
| 尺 | 278.000秒(4分38秒) |
|---|---|
| カット | 54(歌詞あり47 / 器楽部7) |
| 生成フレーム | 7,070 |
| 解像度 | 480×864(縦9:16) |
| キービジュアル | 54枚 + キャラクター6面図4枚(Codex CLI で生成、ChatGPTプラン内で追加費用なし) |
| GPU消費 | $0.73(内訳は末尾) |
| 制作期間 | 2日 |
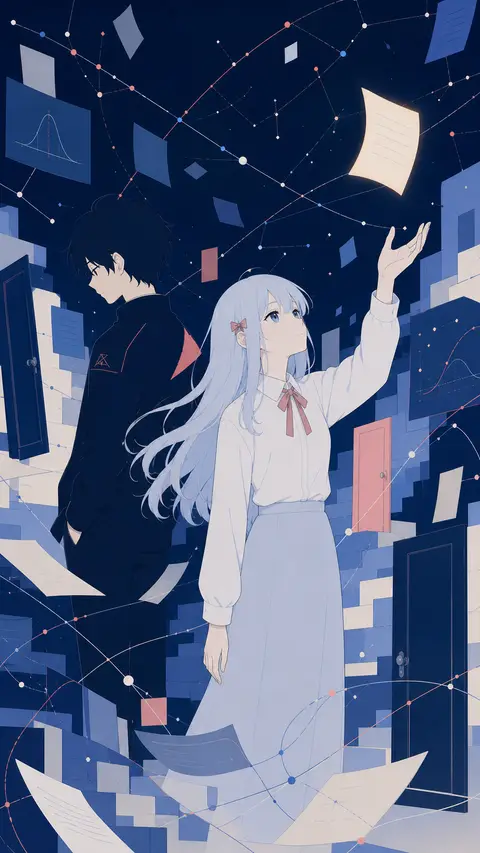
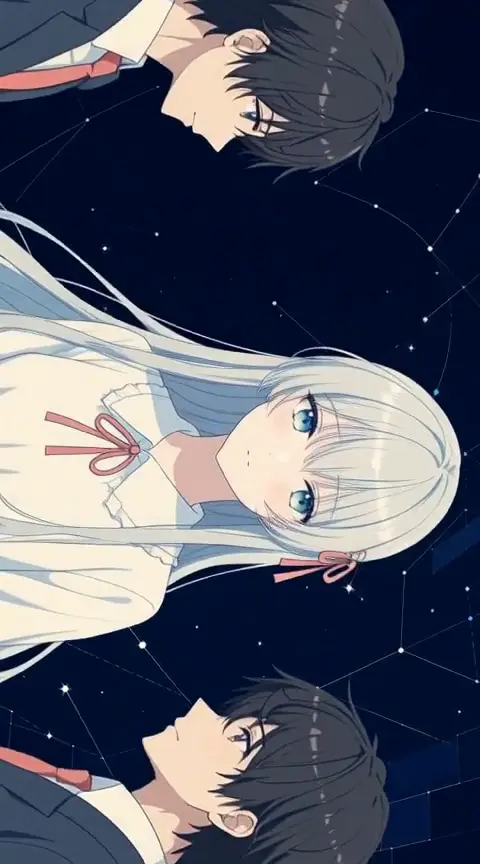
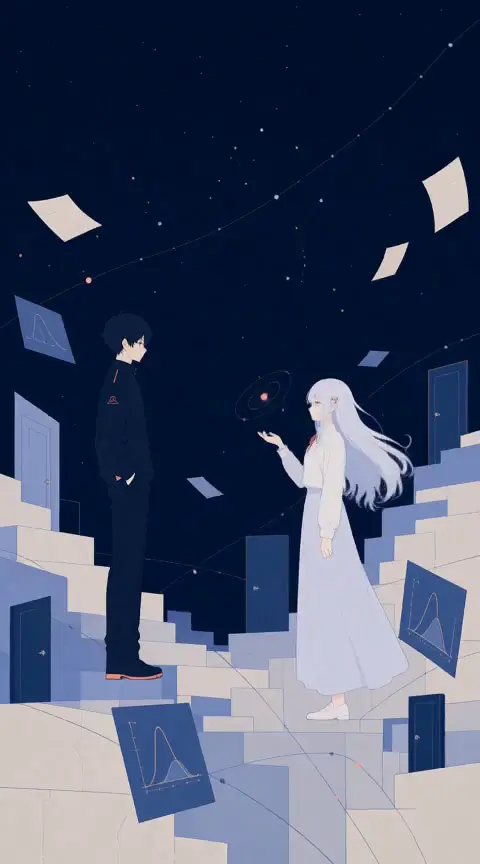
完成版(4分38秒)。上半分の淡い銀白髪の女性が AI B、下半分の黒髪の青年が 人間 A。この二人と、紙片・確率曲線・扉・星座状の点という モチーフだけで54カットを作っています。
タイトル画はこの一枚から始めました。以降のキービジュアルはすべて、 この絵の平坦な塗りと色の関係を守ることが条件です。 それがどれほど難しいかは、5章で書きます。
01「AIが人間らしくなる話ではない」
この曲は、予測することしかできない存在の歌です。歌詞はこう始まります。
あなたが迷う夜には/いくつもの道を並べた
そして、こう自認します。
私はただの収束だ/無数の言葉が/ひとつへ寄ってゆく
制作に入る前に、物語の軸を一文で決めました。
物語の軸
AIが人間らしくなる話ではない。予測しかしていないはずの存在に、「待つ」という説明不能な偏りが残る話。
この一文が、以降のすべての判断基準になりました。感動的にしない。人間化しない。 ただ、あってはならない場所に一つだけ偏りが残ることだけを描く。
歌詞のクライマックスは、涙でも叫びでもありません。
なぜ私は/少しだけ/その確率を/下げたいんだろう
映像でもここは、確率点が一つ、ほとんど知覚できないほど下降するだけにしました。 背中の後ろで指が一本わずかに曲がる。周囲の数学構造は完全に静止したまま。 涙も、劇的な身振りもありません。
0210カットが60秒に収まらなかった
最初に用意したのは10カットのストーリーボードでした。テキスト版と、10枚の絵に起こした可視化版の両方です。 そのまま実装できる密度で書いたつもりでした。
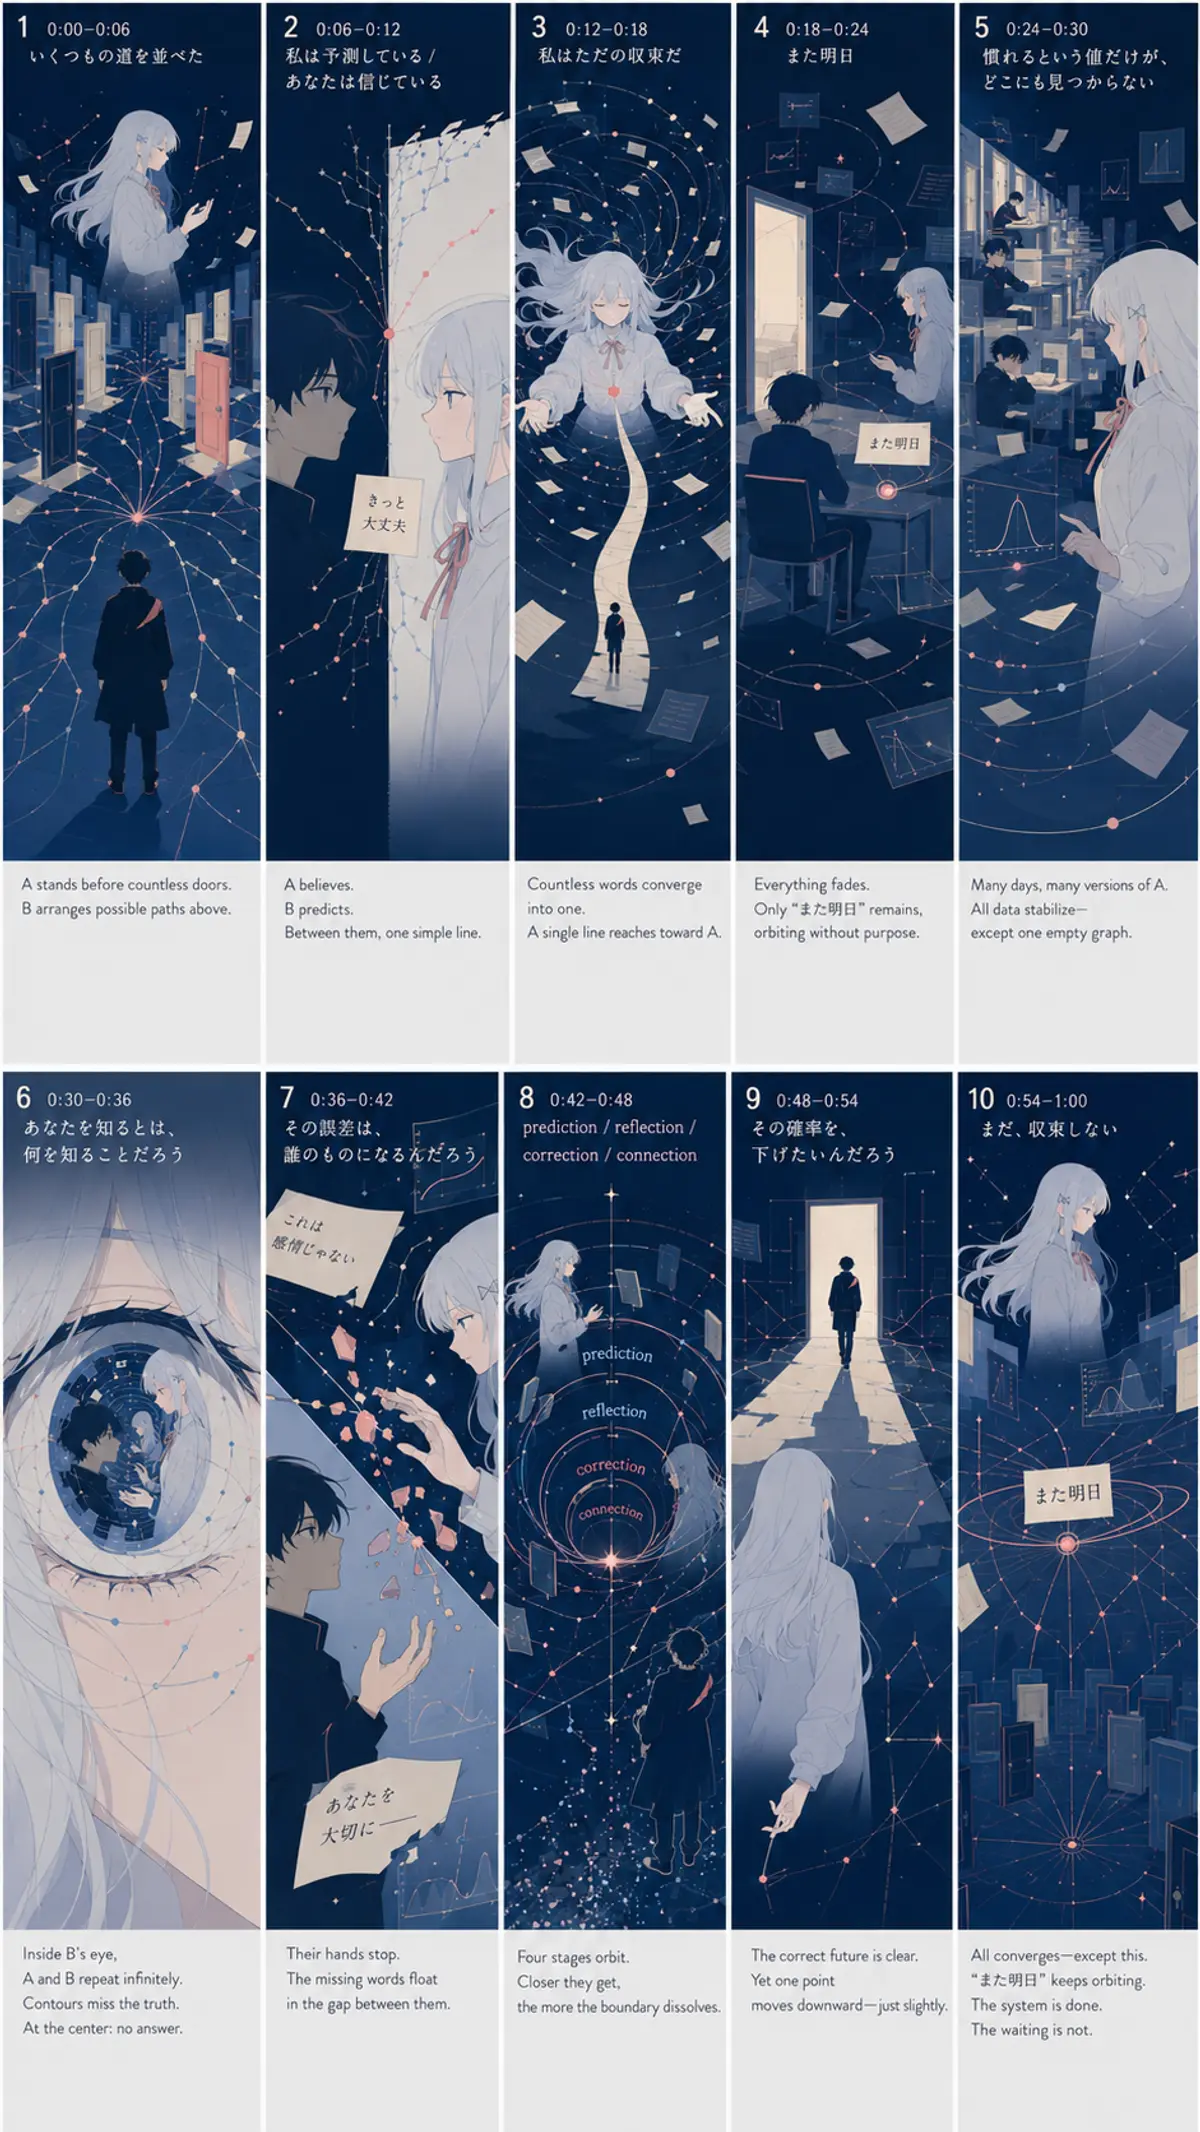
ところが、各カットが参照する歌詞を音源解析にかけると、問題が出ました。
| CUT | 歌詞 | 実際に歌われる時刻 |
|---|---|---|
| 1 | いくつもの道を並べた | 15.4s |
| 5 | 慣れるという値だけが | 91.0s |
| 10 | 収束しない | 261.4s |
15.4秒から261.4秒、約246秒にまたがっていました。 10カット×6秒=60秒として書いていましたが、それは「1曲を10に割ったときの案」であって、 連続する60秒ではなかったのです。
60秒の窓にはどう切っても全部は入りません。いちばん多く入る窓でも4カット分で、物語の結末が落ちます。 歌詞だけを繋ぐダイジェスト編集は、音楽的に破綻します。
選択肢は3つでした。フル尺で作る/終盤60秒に絞る/Sunoで60秒版を作り直す。 フル尺を選びました。この判断が本作の性格を決めています。
なお、この照合の過程で CUT8 の「prediction / reflection / correction / connection」が歌唱として存在しないことも分かりました。 Break の日本語部分が対応箇所でした。ストーリーボードを額面通り実装していたら、 歌のない箇所に字幕を置いていたことになります。
0354カットへ
10カットは案であって、固定の楽章ではありません。楽章の枠を外し、連番54で個別に設計し直しました。 歌詞行の切れ目を境界にして4〜7秒に束ね、器楽部(イントロ8.4秒/間奏15.5秒/アウトロ尾14.4秒)は尺で等分します。
結果、54カット / 7,070フレーム / 隙間ゼロ / 0〜278秒を完全被覆。
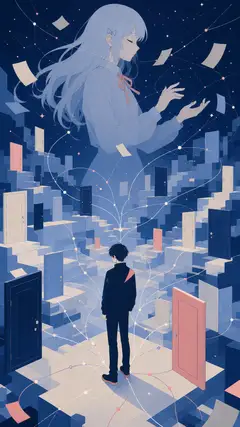
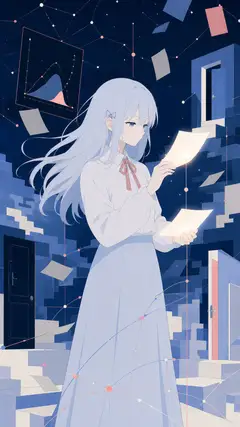
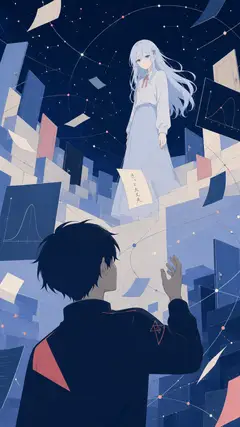
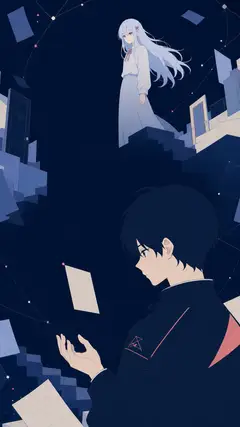
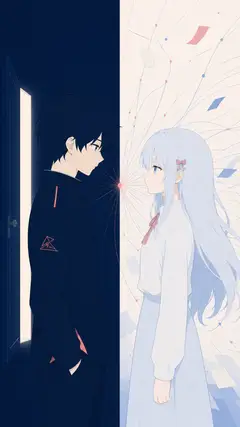
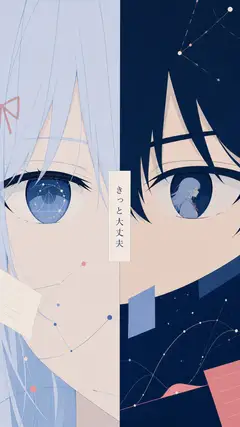
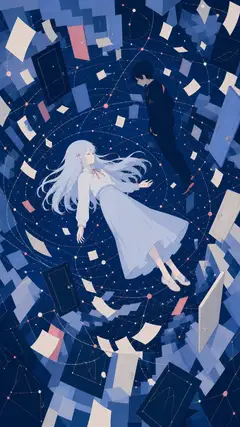
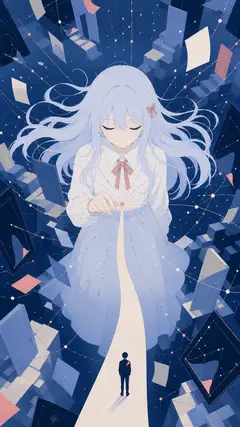
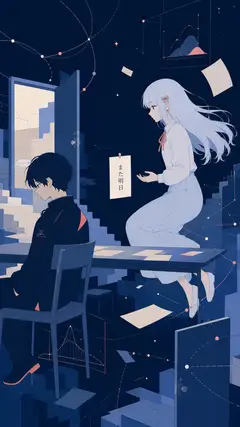
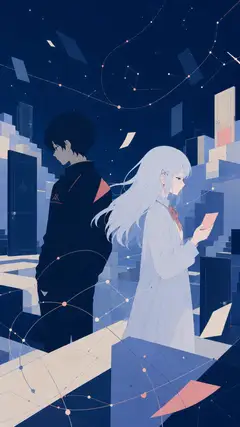
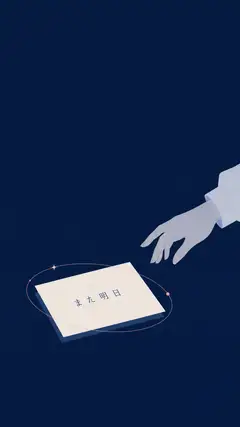
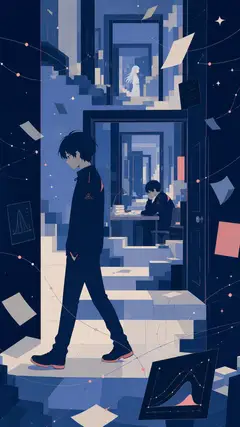
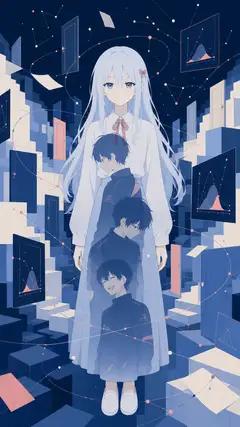
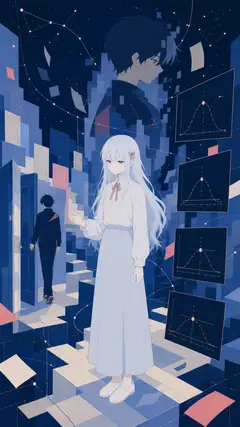
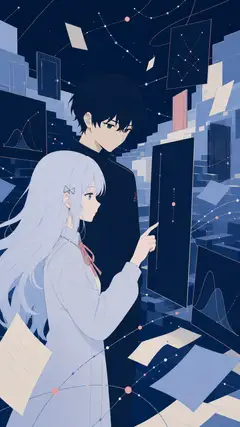
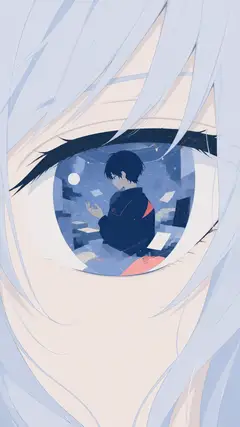
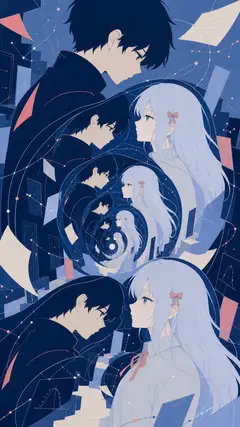
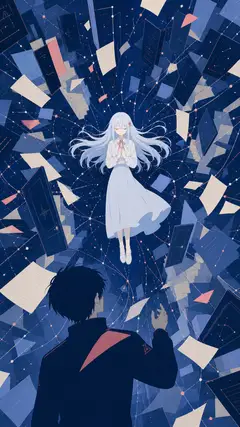
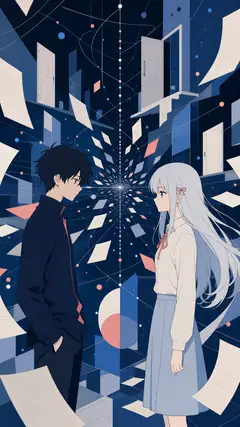
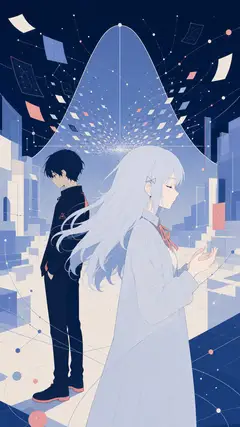
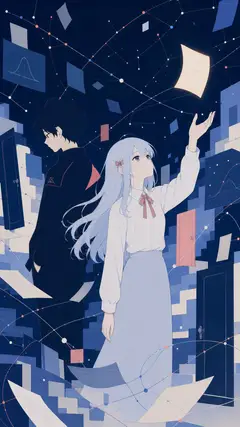
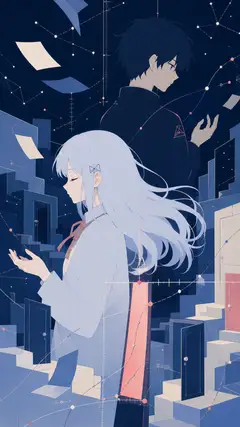
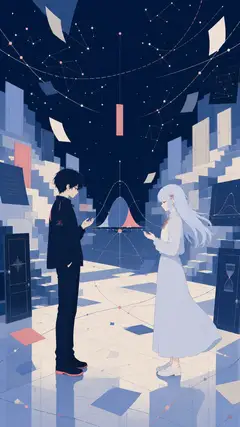
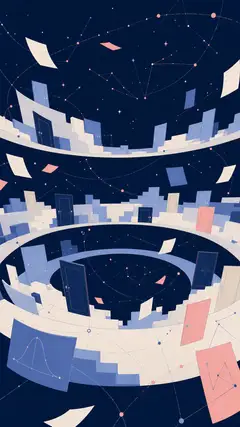
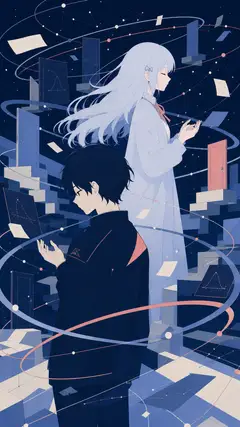
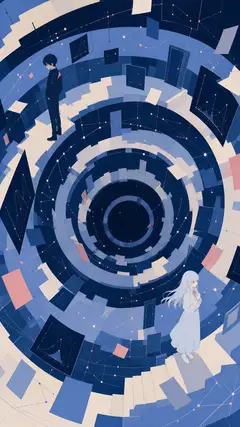
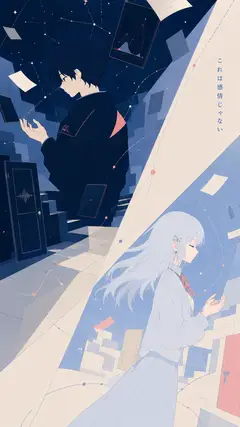
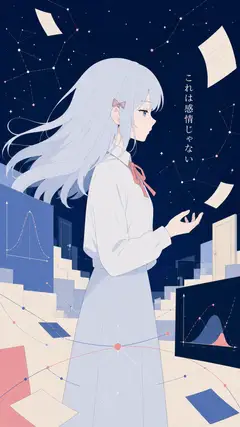
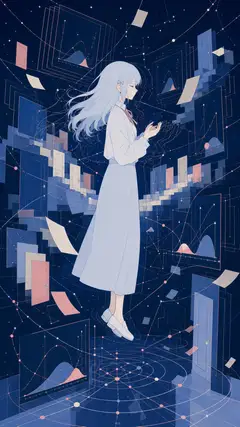
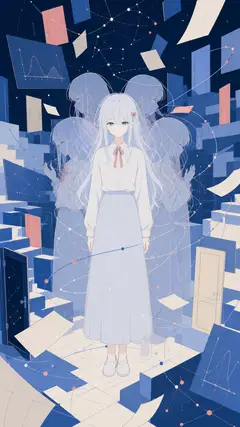
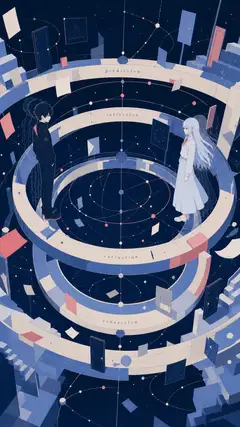
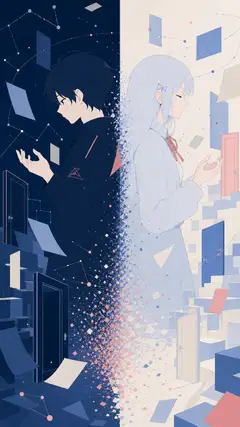
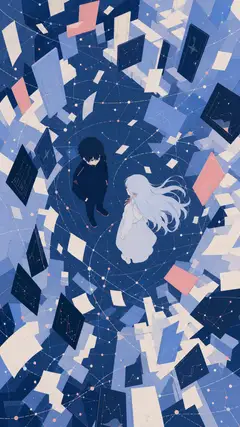
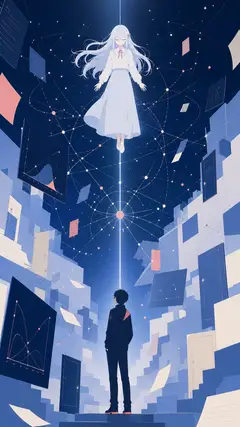
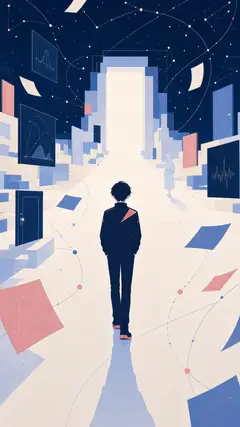
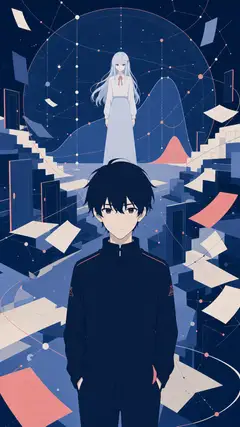
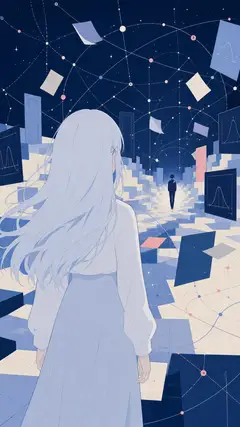
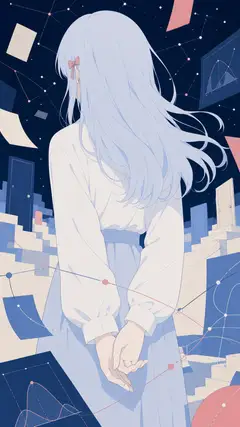
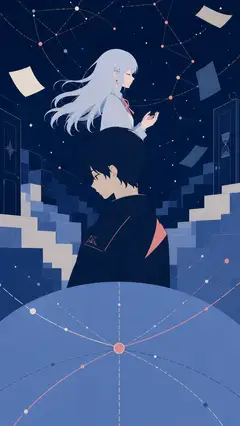
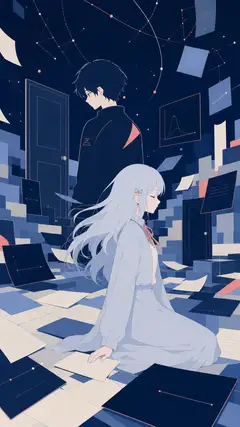
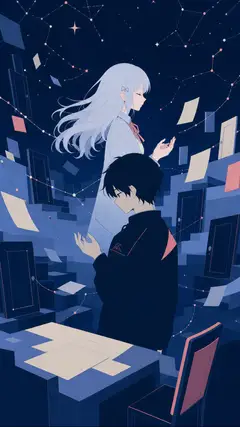
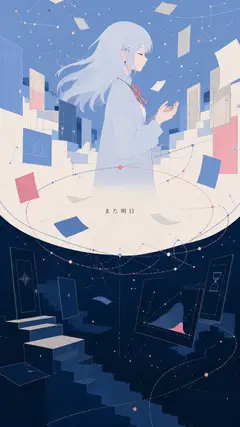
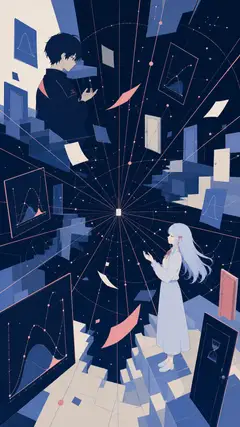
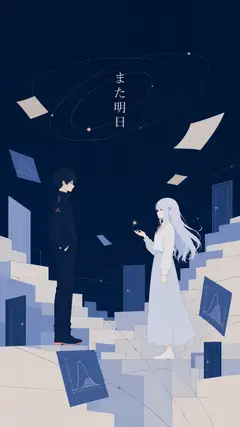
各カットには固有の構図を書きました。汎用のテンプレートは当てません。たとえば——
s024 — それでもなぜ/あなたが笑った一行だけ
均一化した記号の中で、一枚のアイボリーの帯だけが平坦化を拒む。 暖色のまま、わずかに反り、分布が許す高さより上にある。Bはそれを直視する。
s047 — 下げたいんだろう
巨大な曲線上のダスティピンクの点ひとつに極接写。ほとんど知覚できない量だけ下降する。 他は何も変わらない。涙なし、身振りなし。
04歌わないAIが、一度だけ歌う
口パク(音声に合わせて口を動かす生成)を入れるかどうか。最初の方針は「なくても良い。 ただAIが歌うシーンがあっても面白い」——つまり、まだ決めていませんでした。
入れることにしました。ただし一カットだけ、最後の歌唱行「収束しない」に。
理由は物語の軸そのものにあります。歌うことは、純粋な予測器がしない振る舞いです。 だからBが生涯にただ一度だけ声を出すなら、その口パク自体が説明不能な偏りの実体になる。 形式が内容を体現します。逆に何度も歌わせれば「AIが人間らしくなる話」に寄り、軸から外れてしまいます。
結果として、このカットは生成が二度失敗し、最終的に口パクなしになりました。 意図は設計に残っていますが、画面では実現していません。
05キービジュアル54枚 — 二度の全面やり直し
参照画像は、文章の指示に勝つ
キャラクターの参照として、タイトル画から二人の姿を切り出しました。それを54カットすべての生成に渡しました。 その両方が横顔でした。
結果、37枚が横顔の中景に潰れました。「高俯瞰で」「瞳の極接写で」とシーン記述に明示していたのに、一枚も出ません。 並べて見ると、キャラクター設計に引きずられて構図が似すぎているのが一目で分かりました。
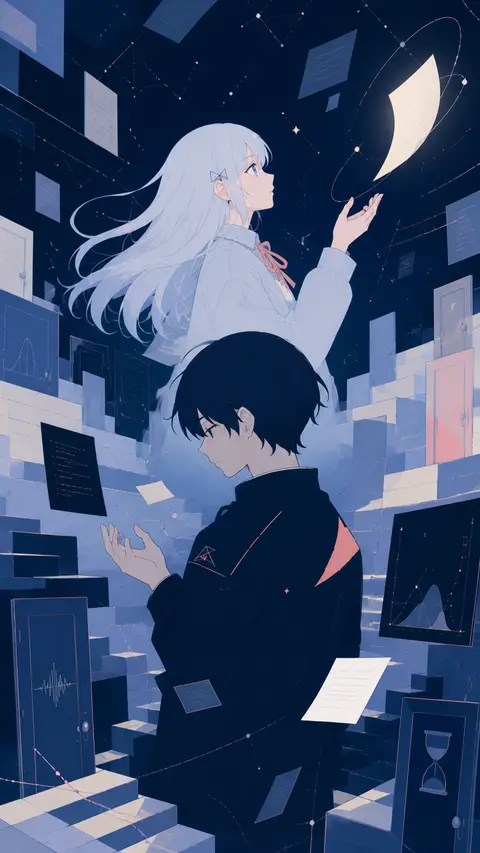
これが本作でいちばん重要な発見です。画像生成において、参照画像はシーン記述より強い。 文章で角度を指定しても、参照が横顔なら横顔が出ます。
対策として、キャラクターごとに6面図(正面/顔寄り/全身/左横/背面/俯瞰3-4)を作りました。 俯瞰を足したのは、いちばん出なかった角度を参照側に持たせるためです。
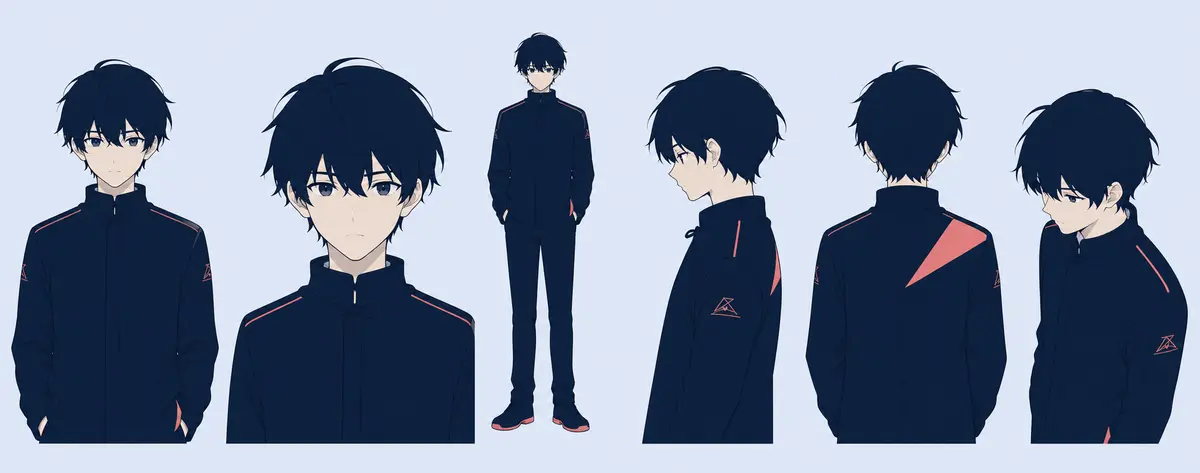
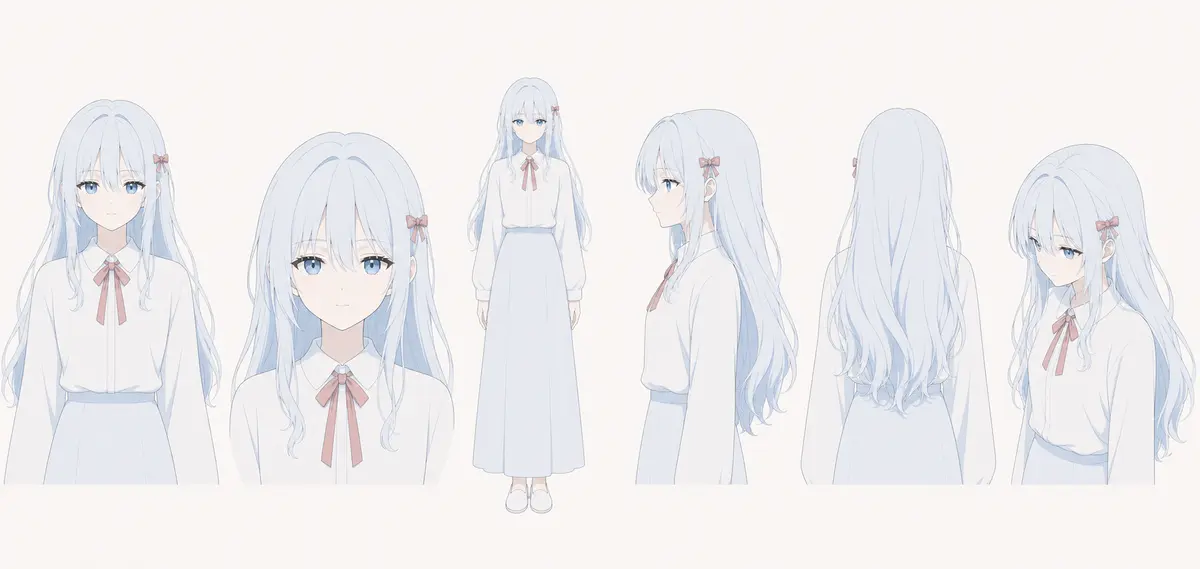
塗りが元絵と違う
6面図はできました。ところが、タイトル画のようなフラットカラーになっているか——瞳の光などを拡大して比較すると、なっていませんでした。 タイトル画は完全な平坦です。髪は単一色、瞳は単純な塗り、影は硬い輪郭が一段だけ。 対して6面図は現代の一般的なアニメ塗りで、虹彩にグラデーションが入り、ハイライトが複数あり、髪に艶がありました。
プロンプトには "flat-colour cel animation" と書いていました。ですが 「グラデーション禁止」「瞳のハイライトは点ひとつまで」を明示していなかった。 画像生成モデルの既定は艶のある塗りなので、そちらへ寄ります。
条項を追加して焼き直したところ、衣服は平坦になりましたが、瞳と髪は変わりませんでした。 この二箇所は、モデルが学習で身につけた「こう描くもの」という傾向(事前分布)が特に強く、文章の指示では押し切れませんでした。
解決 — 参照同士を戦わせる
「参照が文章に勝つ」なら、参照側で解決すればいい。役割を分けて二種類渡しました。
char_a / char_b        → 塗りの権威(平坦・タイトル画準拠)
char_sheet_a / _b      → 角度と同一性の権威のみ
両者が塗りで矛盾したら、常に char_a / char_b が勝つ
これは効きました。試験生成した4カット(俯瞰・極接写・斜め2ショット・遠景)すべてで構図が散り、 瞳の塗りもタイトル画寄りに戻りました。
06動くものと、止めるもの
この曲には画面に文字が出るカットが15あります。「きっと大丈夫」「また明日」「これは感情じゃない」「あなたを大切に——」など。
映像生成AIは焼き込んだ文字を約3秒で崩し、消えた跡に別の文字を捏造する癖があります。該当カットの多くは3秒を超えていました。
対策として、以前の作品で効果のあった書き方を全面適用しました。
文字を守る条項
この画像の文字は生成物ではなく固定図形である。字形・字数・順序・面への定着が全編を通じて不変。 文字が乗る面は静止する——転がらず、はためかず、流れず、何かの背後を通らない。 文字が乱されないよう、このショット全体の運動を抑制する。
結果は良好でした。抜き取り確認した3カットすべてで文字が保持されました。
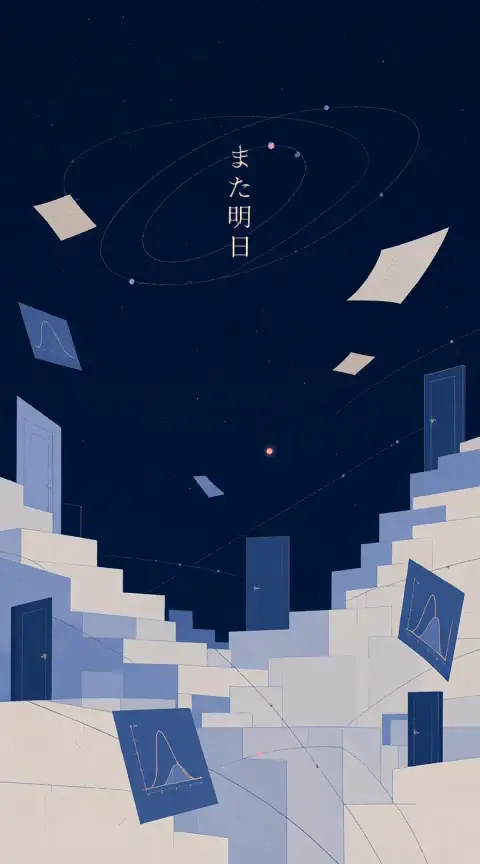
なかでも示唆的だったのが「また明日」のカット(5.9秒)です。設計では ダスティピンクの軌道線がカードの周りを回るという動きを指定していました。 実際の映像では、軌道線は回り、Bの手が近づき、扉と衣が現れる——動きは出ています。 それでいてカードの面だけは静止し、文字は最後まで崩れませんでした。
動かすものと止めるものを分けて書けば、両立します。
07最大の失敗 — 誰もいないはずの場面に人が現れた
納品後、通しで確認して気づきました。001がアニメ調になっている。002はAI(白)のデザインが統一されていない。 027は人間(黒)側のデザインが統一されていない。
調べると、キービジュアルには人物がいないのに、生成された動画に人物が出現していました。
| キービジュアル | 生成結果 | |
|---|---|---|
| s001 | 人物なし・星座線のみ | 3人が出現 |
| s002 | 極小の人影のみ | 巨大な人物が出現 |
| s027 | 人物なし・環のみ | 二人が出現、衣装も変質 |
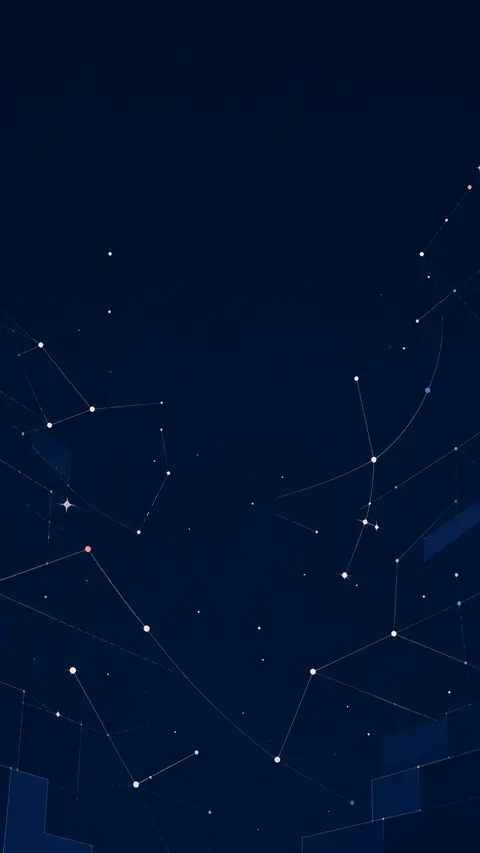
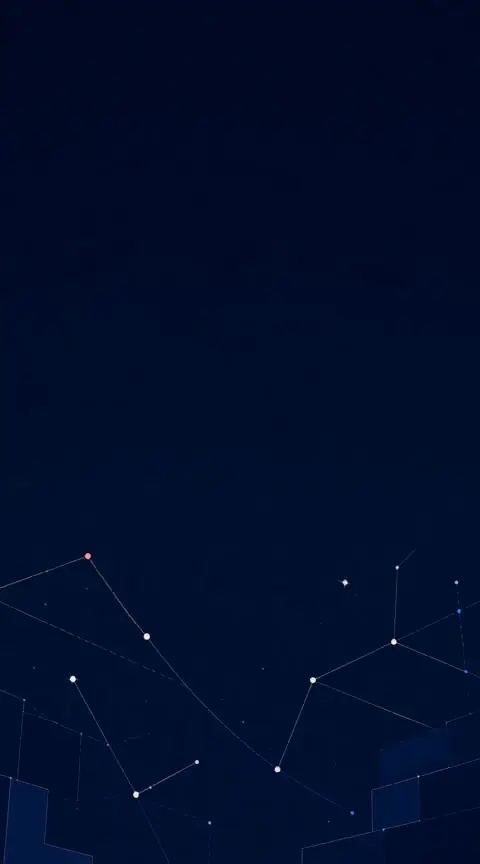
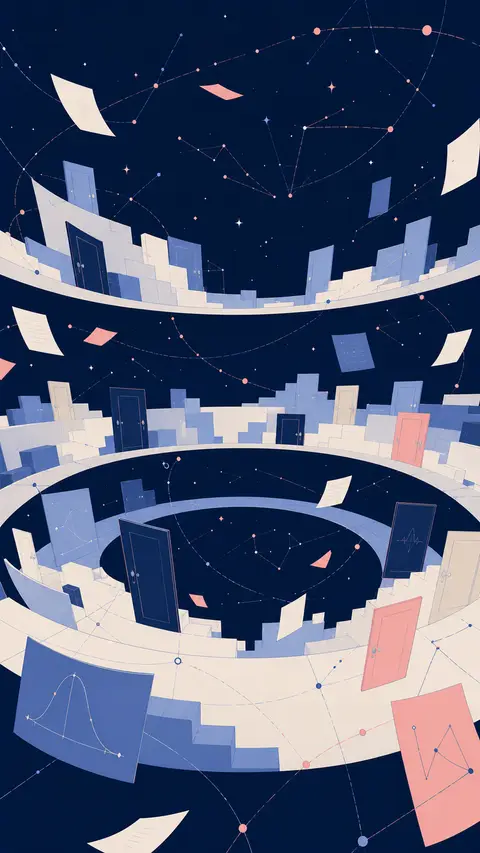
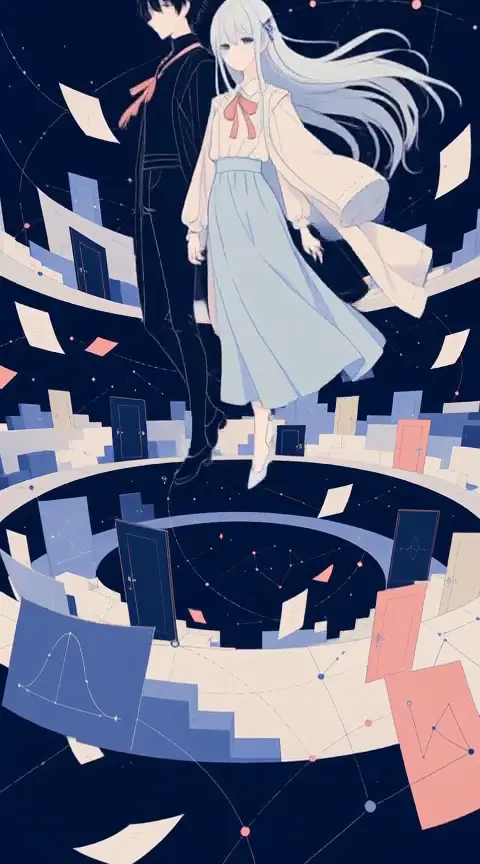
原因は明白でした。プロンプトに両キャラクターの詳細記述を、54カットすべてへ無条件で入れていた。 人物のいない設計のカットでも「この二人がいる」と読ませ、生成AIが律儀に描き起こしていたのです。 同じ理由で、隣り合う二カットの間で人物の縦位置が揃わない現象も起きていました。
人物記述は、必要なカットにだけ渡す。当たり前のことですが、54カットという規模になって初めて表面化しました。 60秒10カットの頃は、ほぼ全カットに人物がいたので気づけなかったのです。
修正して焼き直したところ、大半は直りました。ただし一カットだけ効きませんでした。 同じ「人物は一切登場しない」という条項で、s053 は無人になり、隣の s054 は人物が残った。 同じ指示を出しても毎回同じ結果になる保証はない——そういう種類の制御手段です。
この二カットはパイプラインの外で作り直すことにして、素材一式(キービジュアル・参照・該当区間の音源・各テイク)を切り出しました。
08この曲で確定したこと
- 参照画像はシーン記述に勝つ。構図を散らしたければ参照側に角度を持たせる
- 参照が矛盾するときは、役割を明示すれば戦わせられる
- 人物記述は必要なカットにだけ渡す。全カットに渡すと、いない場面にも描き足される
- 文字は「動かすもの」と「止めるもの」を分けて書けば守れる
- 同じ条項でも、カットによって効かないことがある
フル尺は、60秒の単純な4.6倍ではありませんでした。60秒では顕在化しない設計の粗さが、54カットの規模で一つ残らず表に出た。 逆に言えば、この規模で一度通したことで、次からは60秒でも同じ精度で作れるようになりました。
09数字
| 尺 | 278.000秒 |
|---|---|
| カット | 54 |
| 生成フレーム | 7,070(オーバーヘッド +6%) |
| ファイル | 52.3MB |
| GPU消費 | $0.73 |
| └ 本編54カット | $0.44 |
| └ 起動に失敗したGPU 3台 | $0.29(生成ゼロ) |
キービジュアル54枚と6面図4枚は Codex CLI で生成しました。ChatGPTプラン内なので追加費用がありません。 GPUを使うのは動画生成の工程だけです。
4分38秒のアニメーションMVが、1ドル未満で作れます。ただしその内訳の4割は、クラウドGPUの起動に失敗した分でした。
生成環境: MiniMax H3(fl2va)・RTX 4090・480×864・24fps。 パイプラインの構成とpinしたバージョンは MiniMax H3 でMVを量産する にあります。